
LLM представляет вам неверное значение, извлеченное из документа, как факт. Эта ошибка обходится дорого, особенно если принимать решения на её основе. API для извлечения данных о питательных веществах направлен на решение этой проблемы. Он парсит PDF-файлы, сканы, изображения и файлы Office, преобразуя их в пространственный JSON или Markdown. Вы можете извлекать поля из документа в соответствии со своей схемой JSON, а функции разбиения, классификации и создания форм предоставляют полезные примитивы для ваших конвейеров обработки документов. Каждое извлеченное значение привязывается к странице с помощью ограничивающего прямоугольника, метки соответствия и коэффициента достоверности. Nutrient (ранее PSPDFKit) использует один и тот же движок в рамках сервера MCP, навыка агента, приложения для Mac и SDK.
Краткое содержание
- Размер: Хостинговый API с 4 режимами парсинга и автоматической маршрутизацией.
- Запуск: В облаке Nutrient, на ваших собственных серверах через SDK или на Mac с чипом Apple Silicon.
- Где попробовать: Studio — браузерная рабочая среда для настройки и тестирования парсинга, извлечения, классификации, разбиения и заполнения форм.
- Производительность: 86,2 по общему показателю на WholeDoc Bench от Nutrient, лучший результат среди 19 настроек (живой API, Agentic).
- Лучший: 86,2 при стоимости 1,8 цента за страницу против 67,1 при 17,8 цента для лучшей настройки фронтального модели.
Как протестировать его в Studio перед написанием кода?
Studio — это браузерная рабочая среда Nutrient для настройки и тестирования API перед интеграцией в ваше приложение. Она позволяет тестировать парсинг, извлечение, классификацию, разбиение и заполнение форм на ваших собственных файлах. Типичный цикл:
- Загрузите образец документа и задайте параметры, которые планируете отправлять.
- Составьте схему в интерфейсе или создайте её на основе ваших собственных документов.
- Запустите процесс на новом документе, затем проверьте значения и ссылки.
- Сохраните настройку как версионированный пресет. API называет это процессором с ID proc.
- Оцените версии пресетов по до 25 проверенным документам из набора для оценки.
Процессоры, сохранённые в Studio, затем можно вызывать по ID через API.
Какой режим выбрать?
Авто направляет каждую страницу в режим структура, понимание или агентский. Если режим не указан, API по умолчанию использует режим понимания.
| Операция | Лучше всего подходит для | Цена за страницу | Извлечение за страницу | WholeDoc Bench* |
| Парсинг: текст | Нативные цифровые PDF и файлы Office, без OCR | 0,001 долл. США | 0,007 долл. США** | Не тестировалось |
| Парсинг: структура | OCR для сканов с простыми макетами, без ИИ | 0,0015 долл. США | 0,0075 долл. США | 39,4 |
| Парсинг: понимание | Анализ макета с помощью ИИ: формы, сложные макеты | 0,009 долл. США | 0,015 долл. США | 80,8 |
| Парсинг: агентский | Модель компьютерного зрения: курсив, ухудшенные сканы, диаграммы | 0,018 долл. США | 0,024 долл. США | 86,2 |
| Классификация | Метки документов без обучения | 0,001 долл. США | н/д | н/д |
| Разбиение | Разделение объединённых PDF на отдельные документы | 0,003 долл. США | н/д | н/д |
*Показатель парсинга на WholeDoc Bench, 5 ноября 2026 года; не точность извлечения. Доплата за извлечение составляет 0,006 долл. США за страницу. **В документации API указано извлечение в текстовом режиме; навык агента начинается с режима структура.
Цены указаны в долларах, исходя из одного баланса, общего для облачных API Nutrient, что позволяет командам комбинировать различные варианты. Бесплатный тариф предоставляет ежемесячное использование на 5 долларов, покрывающее около 330 извлечений в режиме понимания. Starter стоит 75 долларов в месяц за 90 долларов использования; Growth — 275 долларов за 345 долларов.
Как работает обоснованная уверенность?
В посте о уверенности Nutrient поле получило оценку 0,97, но было взято из неправильного столбца.
Текущий балл представляет собой композит из необязательных сигналов: вероятность токена, маржа кандидата, основание и формат. Модель основания NLI Nutrient grounding model распространяется по лицензии Apache-2.0. Основанное значение может по-прежнему отвечать на неверное поле. При отсутствии балла уверенность не указывается, а не является низкой.
Каждое поле также получает метку соответствия: id_match, id_match_multiblock, id_match_partial, fuzzy_match или not_found. Сначала проверьте метку, затем уровень уверенности.
Скопировать кодСкопировано Используйте другой браузер
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "Номер счета ниже реквизитов поставщика."},
        "total_amount": {"type": "number", "description": "Итоговая сумма с налогом, указанная на чеке. Не подытог."},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # только для примера; оценивайте на репрезентативных документах

for field in schema["properties"]:  # перебор ожидаемых полей, чтобы ни одно не пропустили проверку
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = нет оценки
    проходит проверку, если: value не равно None и match принадлежит EXACT,
    а также conf не равно None и conf >= THRESHOLD
    print(field, value, match, conf, "страница", meta.get("pageNumber"),
          "ПРОХОДИТ_БАЗОВЫЕ_ПРОВЕРКИ" if passes else "ПРОВЕРКА")
Эта демонстрация охватывает только плоские схемы; в продакшене необходимы проверки типов и бизнес-правил. Порог в 0,97 аналогичен полям сумм в учебнике по ипотеке Nutrient.
Как работают classify и split?
Модель принятия решений по документам управляет функциями classify и split. Nutrient сообщает о F1-мере разделения 96,2% против 63,7% у Jev от Typesafe AI.
Как его используют агенты?
Хостинговый сервер MCP не требует ключа API. Claude Code подключается одной командой:
Скопировать кодСкопировано Используйте другой браузер
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude и Codex также работают через OAuth. Стоимость стандартного агентского режима составляет 0,018 доллара за страницу разбора.
Агенты по программированию могут установить навык document-extraction-api с помощью npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api.
Можно ли запустить локально?
В приложении для Mac документы остаются локальными только при использовании локальной модели. Для полностью офлайн-продакшена требуется SDK.
Как он оценивается на WholeDoc Bench?
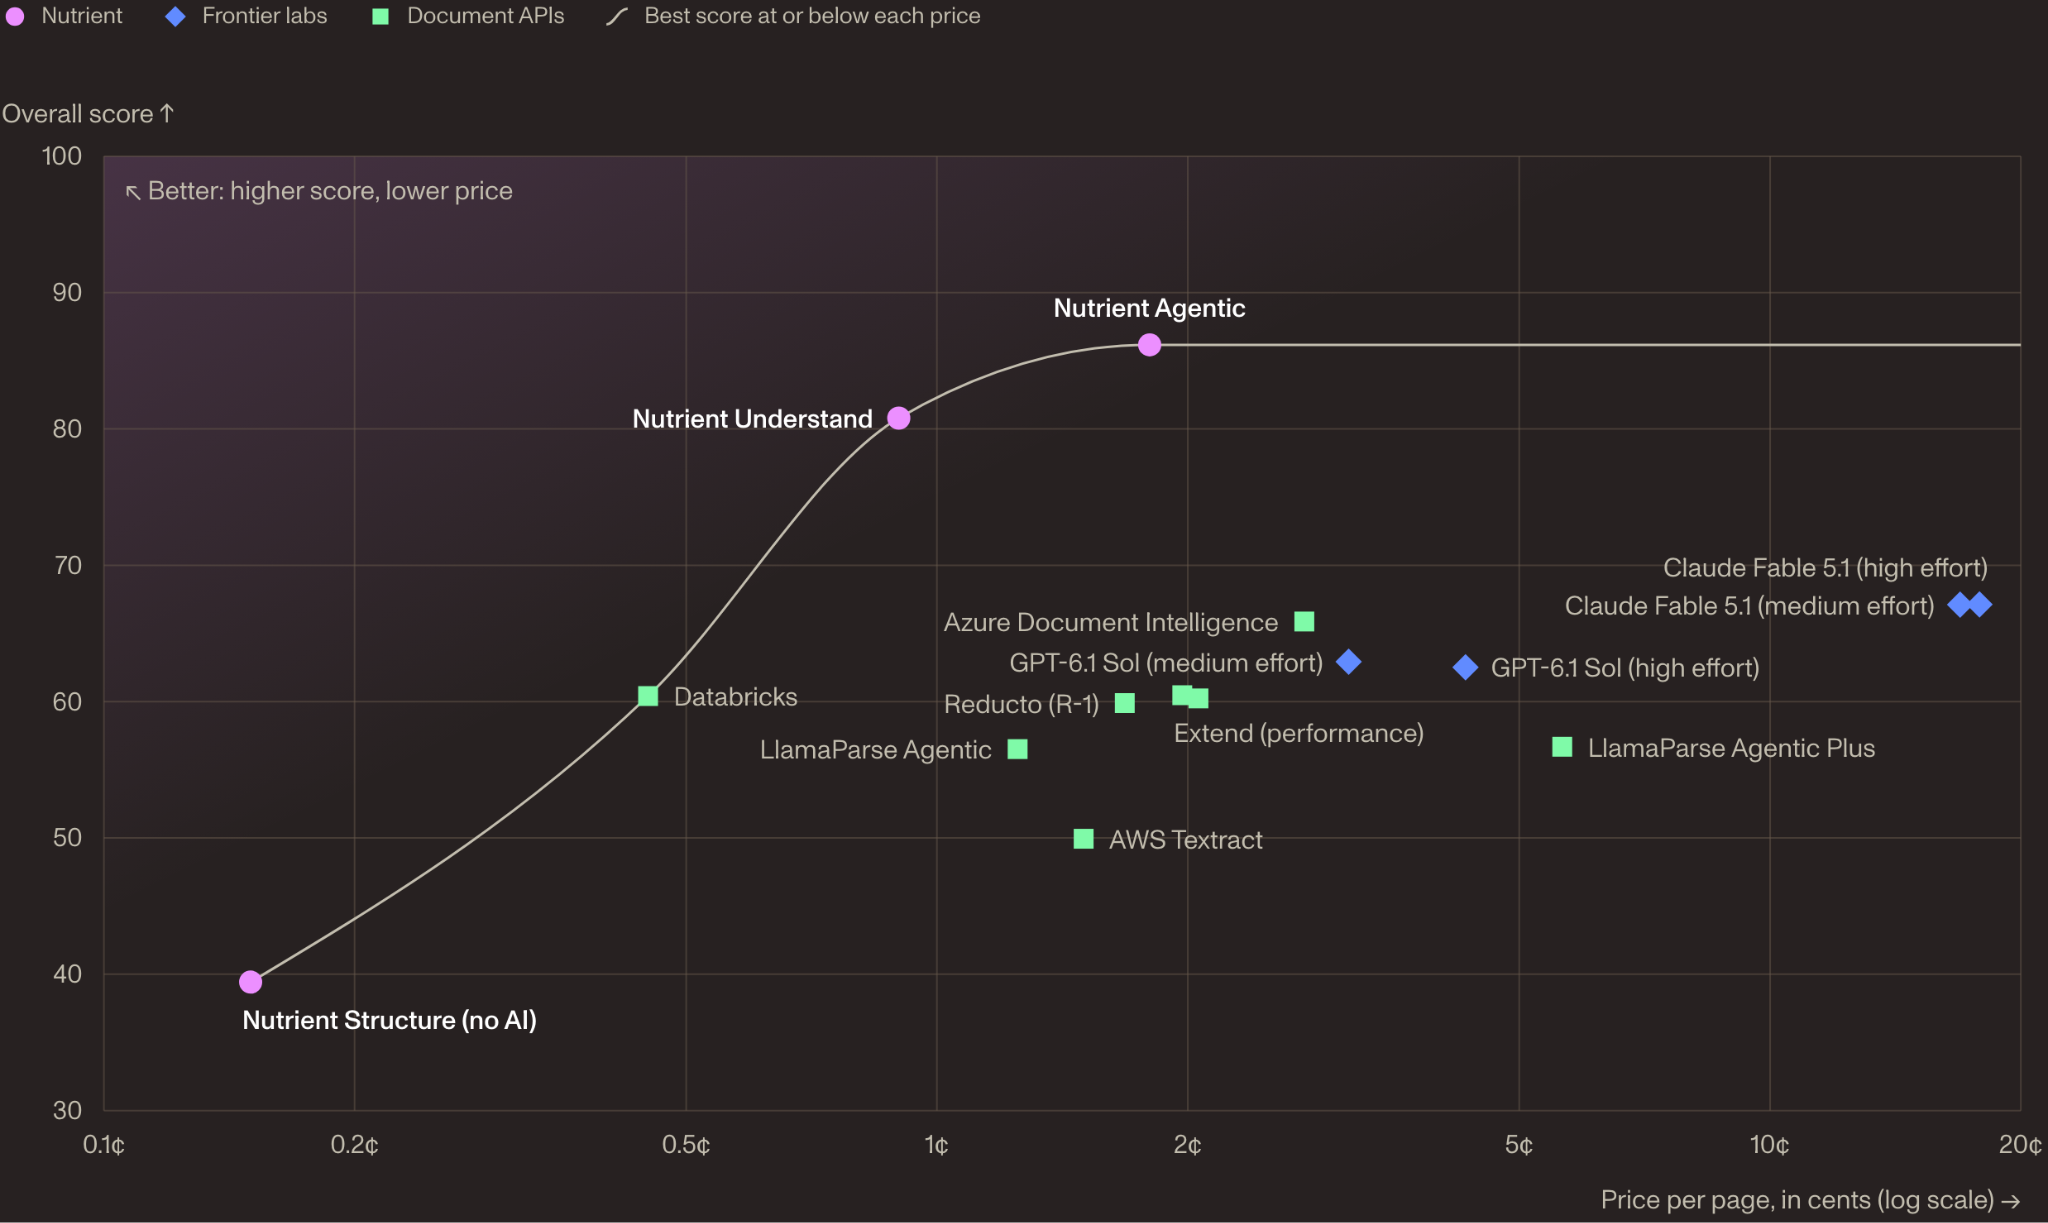
Новая WholeDoc Bench от Nutrient оценивает целые документы, а не отдельные страницы: 480 документов, более 30 языков, 7 областей.
| Настройка | Общая оценка | Таблицы | Графики | Позиция | ¢/страница |
| Nutrient Agentic | 86,2 | 87,1 | 64,5 | 88,6 | 1,8 |
| Nutrient Understand | 80,8 | 86,1 | 35,1 | 86,4 | 0,9 |
| Claude Fable 5.1 (высокие усилия) | 67,1 | 84,7 | 58,9 | 66,0 | 17,8 |
| Azure Document Intelligence | 65,9 | 69,4 | 0 | 72,5 | ≈2,8 |
| GPT-6.1 Sol (средние усилия) | 62,9 | 82,8 | 47,6 | 49,3 | ≈3,1 |
| Extend (производительность) | 60,5 | 80,8 | 40,6 | 75,2 | 2,0 |
| Reducto (R-1) | 59,9 | 76,4 | 38,5 | 76,4 | ≈1,7 |
| LlamaParse Agentic Plus | 56,7 | 89,5 | 0* | 65,4 | ≈5,6 |
| AWS Textract | 49,9 | 71,4 | 0 | 70,0 | 1,5 |
| Docling | 40,0 | 63,9 | 20,2 | 0 | Локальный |
Выбранные строки, рейтинг WholeDoc, 5 ноября 2026 года, цены по списку. *Оценка пока находится на рассмотрении.
Самый большой пробел — сохранение непрерывности между страницами. Из 44 документов с таблицами, охватывающими несколько страниц, в 15 из 19 настроек такие таблицы редко сохранялись целиком.
Nutrient разработала и запустила эту систему, а основной тестовый набор является закрытым. Код распространяется по лицензии Apache-2.0, при этом доступен публичный образец из 10 документов.
Основные выводы
- Поля содержат информацию о страницах, регионах, метках совпадения и, при наличии данных, уровне доверия.
- Перед написанием любого кода API необходимо настроить и протестировать систему в Studio.
- Экстракция в режиме Understand стоит 15 долларов за 1 000 страниц.
- Agentic возглавляет рейтинг WholeDoc от Nutrient с результатом 86,2 при стоимости 1,8 цента за страницу.
- Графики остаются сложной задачей: 64,5 — лучший показатель для графиков в WholeDoc.
См. API извлечения данных, бенчмарки, сервер MCP и навыки агентов на GitHub.
Благодарим команду Nutrient AI за экспертное руководство и предоставленные ресурсы для этой статьи. Статья является спонсорской.
Запись API извлечения данных Nutrient: JSON, соответствующий вашей схеме, с указанием источников и уровнем доверия для каждого поля была опубликована первым на MarkTechPost.