
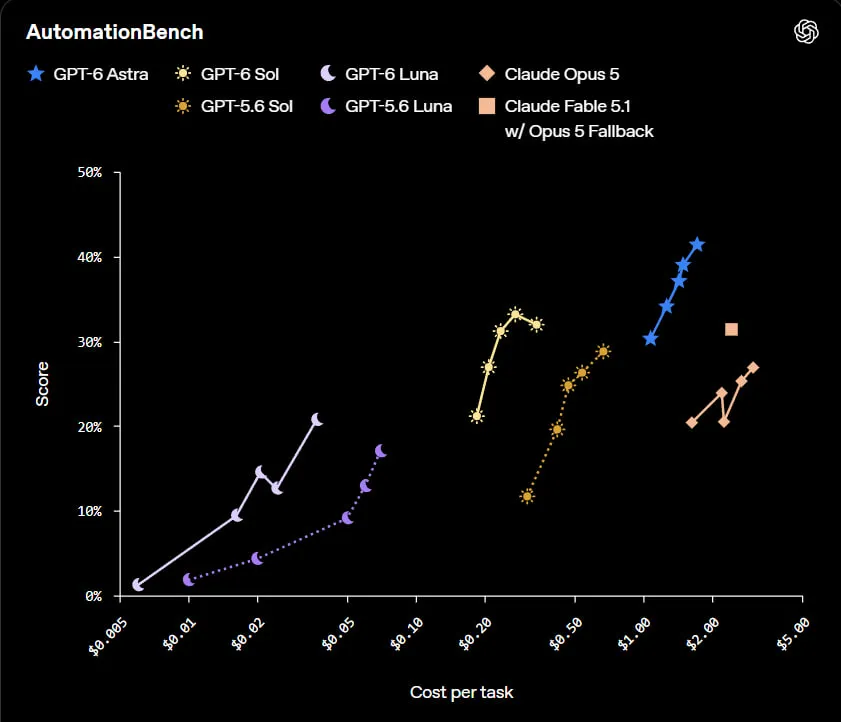
Trong bài kiểm tra các tác vụ thực tế, AutomationBench Sol vượt trội hơn Claude Opus 5 (33,2% so với 26,9%) và Fable 5.1 (31,4%)—đồng thời chi phí thực hiện tác vụ thấp hơn khoảng 11 lần so với Opus 5.
Trong bài kiểm tra nội bộ về lỗi thực tế, Sol giảm số lượng lỗi xuống còn một nửa so với GPT-5.6. Mô hình này đang tiến gần đến độ tin cậy của Astra với mức giá thấp hơn. Các gói API cơ bản cho Sol được giảm 50% (2 USD/10 USD cho mỗi triệu token), còn cho Luna thì giảm từ 50% đến 58%.
Sol dành cho các nhiệm vụ lập trình phức tạp và tác vụ dựa trên tác nhân (phát triển tính năng, rà soát mã, gỡ lỗi, phân tích dữ liệu); Luna dành cho các nhiệm vụ đơn giản và phổ biến hơn như tóm tắt và trích xuất dữ liệu.
Tiếp tục đọc bài viết này tại nguồn: openai.com