
Một mô hình ngôn ngữ lớn (LLM) trình bày cho bạn một giá trị sai được trích xuất từ tài liệu như một thực tế. Sai sót đó gây tốn kém, đặc biệt khi dựa trên đó để đưa ra quyết định. Nutrient Data Extraction API nhắm đến vấn đề này. Nó phân tích cú pháp các tệp PDF, bản scan, hình ảnh và tệp Office thành JSON không gian hoặc Markdown. Trích xuất các trường từ tài liệu theo lược đồ JSON của bạn, đồng thời chức năng chia nhỏ, phân loại và tạo biểu mẫu cung cấp các nguyên tố hữu ích cho quy trình xử lý tài liệu của bạn. Mỗi giá trị được trích xuất đều được gắn với một trang thông qua hộp bao quanh, nhãn khớp và điểm số độ tin cậy. Nutrient (trước đây là PSPDFKit) vận hành cùng một công cụ phía sau máy chủ MCP, kỹ năng tác tử, ứng dụng Mac và SDK.
Tóm tắt nhanh
- Kích thước: Một API được lưu trữ với 4 chế độ phân tích cú pháp cộng với định tuyến tự động.
- Chạy trên: Đám mây Nutrient, máy chủ của riêng bạn thông qua SDK, hoặc máy Mac sử dụng chip Apple Silicon.
- Nơi dùng thử: Studio, một môi trường làm việc trên trình duyệt để cấu hình và kiểm tra việc phân tích cú pháp, trích xuất, phân loại, chia nhỏ và điền biểu mẫu.
- Hiệu suất: 86,2 tổng thể trên WholeDoc Bench của Nutrient, đứng đầu trong 19 cài đặt (API trực tiếp, Agentic).
- Tốt nhất: 86,2 với chi phí 1,8¢ mỗi trang, so với 67,1 ở mức 17,8¢ cho cài đặt mô hình biên giới tốt nhất.
Làm thế nào để bạn kiểm tra nó trong Studio trước khi viết code?
Studio là môi trường làm việc trên trình duyệt của Nutrient để cấu hình và kiểm tra API trước khi tích hợp vào ứng dụng của bạn. Nó cho phép bạn kiểm tra việc phân tích cú pháp, trích xuất, phân loại, chia nhỏ và điền biểu mẫu trên các tệp của riêng mình. Một vòng lặp điển hình:
- Tải lên một tài liệu mẫu và thiết lập các tham số bạn dự định gửi.
- Soạn thảo một lược đồ trong giao diện người dùng, hoặc tạo một lược đồ dựa trên các tài liệu của riêng bạn.
- Chạy thử trên một tài liệu mới, sau đó kiểm tra các giá trị và trích dẫn.
- Lưu cấu hình dưới dạng một preset có phiên bản. API gọi đó là bộ xử lý, kèm theo ID proc.
- Đánh giá các phiên bản preset so với tối đa 25 tài liệu đã được xem xét trong bộ đánh giá.
Các bộ xử lý được lưu trong Studio sau đó có thể được gọi từ API bằng ID.
Bạn nên chọn chế độ nào?
Auto định tuyến mỗi trang sang structure, understand hoặc agentic. Nếu chế độ bị bỏ qua, API sẽ mặc định sử dụng understand.
| Thao tác | Tốt nhất cho | Giá mỗi trang | Trích xuất mỗi trang | WholeDoc Bench* |
| Phân tích cú pháp: văn bản | Các tệp PDF và Office sinh ra ở dạng số, không cần OCR | 0,001 USD | 0,007 USD** | Chưa thử nghiệm |
| Phân tích cú pháp: structure | OCR cho bản scan có bố cục đơn giản, không dùng AI | 0,0015 USD | 0,0075 USD | 39,4 |
| Phân tích cú pháp: understand | Phân tích bố cục bằng AI: biểu mẫu, bố cục phức tạp | 0,009 USD | 0,015 USD | 80,8 |
| Phân tích cú pháp: agentic | Mô hình ngôn ngữ thị giác: chữ viết tay, bản scan bị suy giảm, biểu đồ | 0,018 USD | 0,024 USD | 86,2 |
| Phân loại | Nhãn tài liệu zero-shot | 0,001 USD | n/a | n/a |
| Chia nhỏ | Tách các tệp PDF đã hợp nhất thành nhiều tài liệu | 0,003 USD | n/a | n/a |
*Điểm phân tích cú pháp trên WholeDoc Bench, ngày 5 tháng 11 năm 2026; không phải độ chính xác của việc trích xuất. Trích xuất tính thêm 0,006 USD mỗi trang. **Tài liệu API liệt kê trích xuất ở chế độ văn bản; kỹ năng tác tử bắt đầu ở chế độ structure.
Giá được tính bằng đô la, dựa trên 1 đơn vị sử dụng chung cho các API đám mây của Nutrient, cho phép các đội ngũ linh hoạt kết hợp. Gói miễn phí cung cấp 5 USD sử dụng hàng tháng, đủ cho khoảng 330 lần trích xuất ở chế độ hiểu. Gói Starter có giá 75 USD/tháng với 90 USD sử dụng; gói Growth có giá 275 USD cho 345 USD.
Cơ chế hoạt động của độ tin cậy có căn cứ như thế nào?
Trong bài đăng về độ tin cậy của Nutrient, một trường được chấm 0,97 nhưng lại lấy dữ liệu từ cột sai.
Điểm số hiện tại là tổng hợp từ các tín hiệu tùy chọn: xác suất token, biên độ ứng cử viên, căn cứ và định dạng. Mô hình căn cứ NLI của Nutrient được phát hành mở theo giấy phép Apache-2.0. Một giá trị có căn cứ vẫn có thể trả lời sai trường. Khi không có điểm số, độ tin cậy sẽ bị bỏ qua chứ không phải được đánh giá thấp.
Mỗi trường cũng nhận được một nhãn đối sánh: id_match, id_match_multiblock, id_match_partial, fuzzy_match hoặc not_found. Hãy kiểm tra nhãn trước, sau đó mới đến độ tin cậy.
Sao chép mãSao chépSử dụng trình duyệt khác
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "Số hóa đơn nằm dưới thông tin nhà cung cấp."},
        "total_amount": {"type": "number", "description": "Tổng cuối cùng in ra bao gồm thuế. Không phải tổng phụ."},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # chỉ mang tính minh họa; hãy đánh giá trên các tài liệu đại diện

for field in schema["properties"]:  # lặp qua các trường dự kiến để đảm bảo không bỏ sót bất kỳ trường nào cần xem xét
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = không có điểm số
    passes = (value is not None và match thuộc EXACT
              và conf is not None và conf >= THRESHOLD)
    print(field, value, match, conf, "trang", meta.get("pageNumber"),
          "PASSES_BASIC_CHECKS" nếu đạt, ngược lại là "REVIEW")
Bản demo này chỉ hỗ trợ các lược đồ phẳng; sản phẩm thực tế cần thêm các kiểm tra kiểu và quy tắc nghiệp vụ. Ngưỡng 0,97 phản ánh các trường tiền tệ trong hướng dẫn thế chấp của Nutrient.
Cách thức hoạt động của classify và split như thế nào?
Model quyết định tài liệu cung cấp năng lực cho classify và split. Nutrient báo cáo F1 phân tách đạt 96,2% so với 63,7% của Jev từ Typesafe AI.
Các tác nhân sử dụng nó ra sao?
Máy chủ MCP được lưu trữ không yêu cầu khóa API. Claude Code kết nối chỉ với 1 lệnh:
Sao chép mãSao chépSử dụng trình duyệt khác
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude và Codex cũng hoạt động thông qua OAuth. Chế độ tác nhân mặc định có chi phí 0,018 USD/trang để phân tích.
Các tác nhân lập trình có thể cài đặt kỹ năng document-extraction-api bằng npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api.
Nó có thể chạy cục bộ không?
Trên ứng dụng Mac, tài liệu chỉ được giữ cục bộ khi sử dụng mô hình cục bộ. Sản xuất hoàn toàn ngoại tuyến cần SDK.
Nó đạt điểm số như thế nào trên WholeDoc Bench?
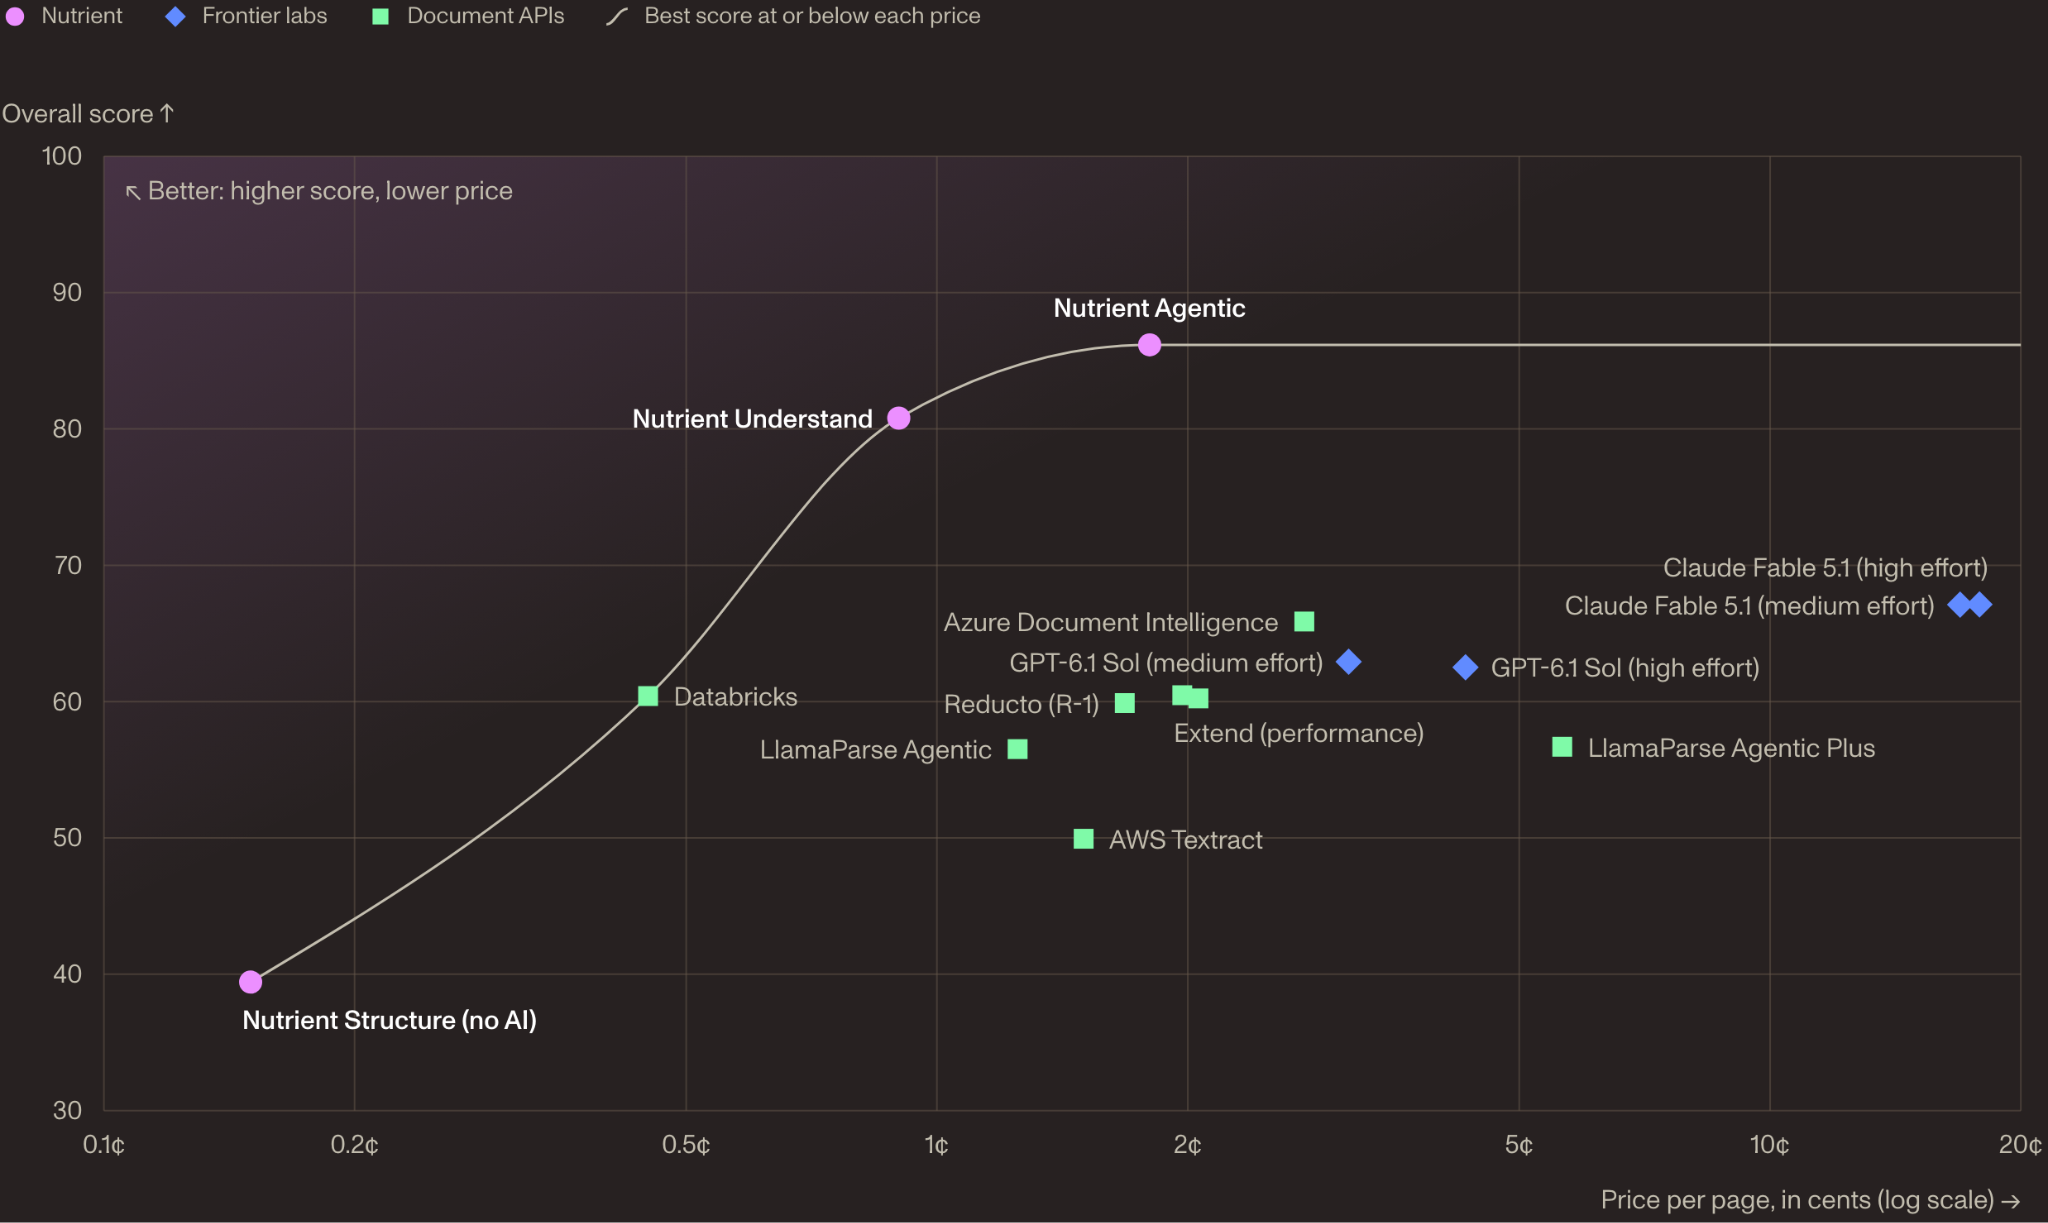
Phiên bản mới WholeDoc Bench của Nutrient chấm điểm toàn bộ tài liệu, không phải từng trang riêng lẻ: 480 tài liệu, hơn 30 ngôn ngữ, 7 lĩnh vực.
| Cài đặt | Tổng thể | Bảng | Biểu đồ | Vị trí | ¢/trang |
| Nutrient Agentic | 86.2 | 87.1 | 64.5 | 88.6 | 1.8 |
| Nutrient Understand | 80.8 | 86.1 | 35.1 | 86.4 | 0.9 |
| Claude Fable 5.1 (nỗ lực cao) | 67.1 | 84.7 | 58.9 | 66.0 | 17.8 |
| Azure Document Intelligence | 65.9 | 69.4 | 0 | 72.5 | ≈2.8 |
| GPT-6.1 Sol (nỗ lực trung bình) | 62.9 | 82.8 | 47.6 | 49.3 | ≈3.1 |
| Extend (hiệu suất) | 60.5 | 80.8 | 40.6 | 75.2 | 2.0 |
| Reducto (R-1) | 59.9 | 76.4 | 38.5 | 76.4 | ≈1.7 |
| LlamaParse Agentic Plus | 56.7 | 89.5 | 0* | 65.4 | ≈5.6 |
| AWS Textract | 49.9 | 71.4 | 0 | 70.0 | 1.5 |
| Docling | 40.0 | 63.9 | 20.2 | 0 | Local |
Các hàng được chọn, bảng xếp hạng WholeDoc, ngày 5 tháng 11 năm 2026, giá niêm yết. *Điểm số vẫn đang trong quá trình đánh giá.
Tính liên tục xuyên trang là khoảng trống lớn nhất. Trong số 44 tài liệu có bảng trải rộng nhiều trang, 15 trong số 19 cài đặt hiếm khi giữ nguyên vẹn các bảng này.
Nutrient đã xây dựng và chạy thử nghiệm, và bộ dữ liệu kiểm tra chính là nội bộ. Mã nguồn sử dụng giấy phép Apache-2.0, kèm theo mẫu công khai gồm 10 tài liệu.
Những điểm chính
- Các trường chứa thông tin về trang, vùng, nhãn khớp và, nếu có, độ tin cậy.
- Hãy cấu hình và kiểm tra trong Studio trước khi viết bất kỳ đoạn mã API nào.
- Trích xuất ở chế độ Understand có giá 15 USD cho mỗi 1.000 trang.
- Agentic dẫn đầu Bảng xếp hạng WholeDoc của Nutrient với 86.2 điểm, tương đương 1.8¢ mỗi trang.
- Biểu đồ vẫn là thách thức: 64.5 là điểm số tốt nhất cho biểu đồ trên WholeDoc.
Xem API Trích xuất Dữ liệu, các tiêu chuẩn so sánh, máy chủ MCP và kỹ năng tác nhân trên GitHub.
Cảm ơn đội ngũ AI Nutrient đã đóng góp tầm nhìn chiến lược và nguồn lực cho bài viết này. Bài viết này được tài trợ.
Bài đăng API Trích xuất Dữ liệu Nutrient: JSON khớp với lược đồ của bạn kèm theo trích dẫn và độ tin cậy theo từng trường đã xuất hiện lần đầu trên MarkTechPost.