
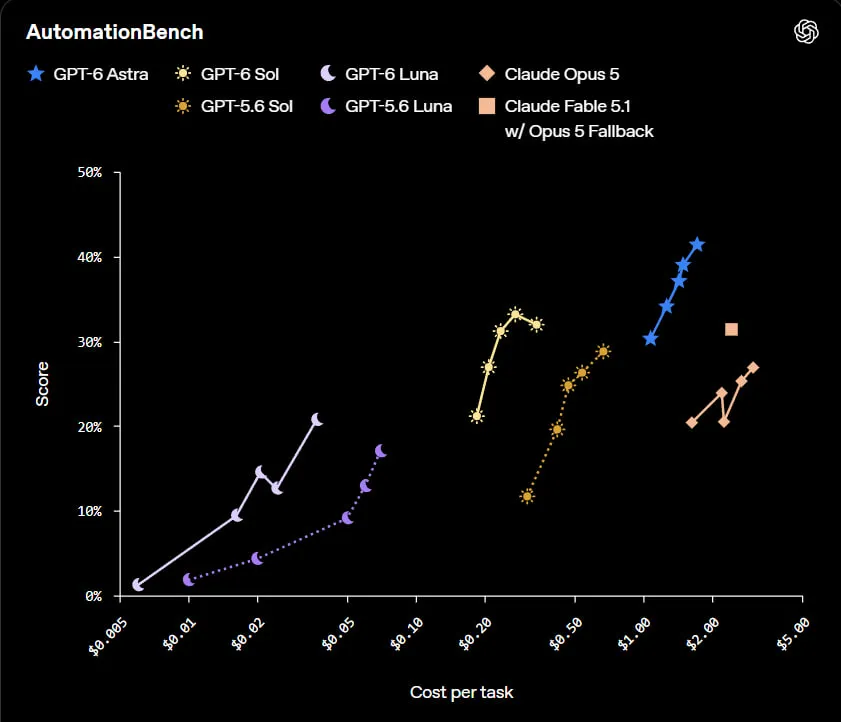
У тестуванні робочих завдань AutomationBench Sol обходить Claude Opus 5 (33,2% проти 26,9%) та Fable 5.1 (31,4%) — при цьому виконання завдання обходиться приблизно в 11 разів дешевше, ніж у Opus 5.
У внутрішньому тесті на фактичні помилки у Sol стало вдвічі менше порівняно з GPT-5.6. Модель наближається за надійністю до Astra, маючи при цьому нижчу ціну. Базові тарифи API для Sol знижені на 50% ($2/$10 за мільйон токенів), для Luna — на 50–58%.
Sol — для складного кодування та агентних завдань (розробка фіч, огляд коду, дебагування, аналіз даних), Luna — для більш простих і масових завдань, таких як саммаризація та витягування даних.
Продовжити читання цієї статті в джерелі: openai.com