
LLM подає вам помилкове значення, видобуте з документа, як факт. Ця помилка має серйозні наслідки, особливо коли рішення приймаються на її основі. Nutrient Data Extraction API спрямований саме на вирішення цієї проблеми. Він парсить PDF-файли, скани, зображення та Office-файли у просторовий JSON або Markdown. Видобуто поля з документа можна прив'язати до вашої схеми JSON, а функції розщеплення, класифікації та формування ендпоінтів забезпечують корисні примітиви для ваших конвеєрів обробки документів. Кожне видобуте значення прив'язане до сторінки за допомогою межового боксу, позначки збігу та оцінки достовірності. Nutrient (раніше PSPDFKit) використовує один і той же движок, що й за MCP сервером, навичками агента, Mac-додатком та SDK.
Коротко
- Розмір: Хостинговий API з 4 режимами парсингу та автомережуванням.
- Працює на: хмарі Nutrient, ваших власних серверах через SDK або Mac з чипом Apple Silicon.
- Де спробувати: Studio — браузерний робочий простір для налаштування та тестування парсингу, видобутку, класифікації, розщеплення та заповнення форм.
- Продуктивність: 86,2 загалом на WholeDoc Bench від Nutrient, найвищий показник серед 19 налаштувань (живий API, Agentic).
- Найкращий: 86,2 при 1,8¢ за сторінку проти 67,1 при 17,8¢ за сторінку для найкращого налаштування frontier-model.
Як перевірити його в Studio перед написанням коду?
Studio — це браузерний робочий простір Nutrient для налаштування та тестування API перед інтеграцією його в ваш додаток. Він дозволяє тестувати парсинг, видобуток, класифікацію, розщеплення та заповнення форм на ваших власних файлах. Типовий цикл:
- Завантажте зразковий документ і встановіть параметри, які плануєте надсилати.
- Складіть схему в інтерфейсі або згенеруйте її на основі ваших власних документів.
- Запустіть процес на новому документі, потім перевірте значення та посилання.
- Збережіть налаштування як версійний пресет. API називає це процесором з ID proc_.
- Оцінюйте версії пресетів на основі до 25 перевірених документів у наборі оцінки.
Процесори, збережені в Studio, потім можна викликати через API за ID.
Який режим обрати?
Auto направляє кожну сторінку до structure, understand або agentic. Якщо режим не вказано, API за замовчуванням використовує understand.
| Операція | Найкраще підходить для | Ціна за сторінку | Видобуток за сторінку | WholeDoc Bench* |
| Парсинг: текст | Будинок-цифрові PDF та Office-файли, без OCR | $0,001 | $0,007** | Не тестувалося |
| Парсинг: structure | OCR для сканів з простими макетами, без ШІ | $0,0015 | $0,0075 | 39,4 |
| Парсинг: understand | Аналіз макетів ШІ: форми, складні макети | $0,009 | $0,015 | 80,8 |
| Парсинг: agentic | Модель бачення та мови: курсив, пошкоджені скани, діаграми | $0,018 | $0,024 | 86,2 |
| Класифікація | Мітки документів без навчання | $0,001 | n/a | n/a |
| Розщеплення | Розділення об'єднаних PDF на окремі документи | $0,003 | n/a | n/a |
*WholeDoc Bench — результат парсингу, 5 листопада 2026 року; не точність видобутку. Видобуток додає $0,006 за сторінку. **У документації API зазначено видобуток у текстовому режимі; навичка агента починається з режиму structure.
Ціни вказано в доларах, з одного балансу, що спільно використовується через хмарні API Nutrient, тож команди можуть комбінувати різні варіанти. Безкоштовний план надає 5 доларів на місяць, що покриває близько 330 витягів у режимі розуміння. Starter коштує 75 доларів на місяць за 90 доларів використання; Growth коштує 275 доларів за 345 доларів.
Як працює обґрунтована впевненість?
У пості про довіру Nutrient було вказано значення 0,97 для одного показника, але воно походило з неправильного стовпця.
Поточний бал є композитним показником необов’язкових сигналів: ймовірності токена, маржі кандидата, підстави та формату. Модель підстави NLI Nutrient grounding model відкрита за ліцензією Apache-2.0. Підтверджена значення все ще може відповідати невідповідному полю. Коли бал відсутній, довіра опускається, а не вважається низькою.
Кожне поле також отримує позначку збігу: id_match, id_match_multiblock, id_match_partial, fuzzy_match або not_found. Спочатку перевіряйте позначку, потім — впевненість.
Скопіювати кодСкопійованоВикористайте інший браузер
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "Номер рахунку-фактури під реквізитами постачальника."},
        "total_amount": {"type": "number", "description": "Друкована кінцева сума з урахуванням податку. Не загальна сума."},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # лише для ілюстрації; оцінюйте на репрезентативних документах

for field in schema["properties"]:  # перебір очікуваних полів, щоб жодне не пропустили перевірку
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = без оцінки
    проходить перевірку, якщо: значення існує, збіг у EXACT, а впевненість існує та ≥ THRESHOLD
    print(field, value, match, conf, "сторінка", meta.get("pageNumber"),
          "ПРОХОДИТЬ ОСНОВНІ ПЕРЕВІРКИ" if passes else "ПЕРЕГЛЯД")
Цей демонстраційний приклад охоплює лише плоскі схеми; у продакшні потрібні перевірки типів та бізнес-правил. Бар 0.97 відображає поля грошових сум у посібнику з іпотеки Nutrient.
Як працюють classify та split?
Модель прийняття рішень щодо документів забезпечує функції classify та split. Nutrient повідомляє про F1-показник розділення 96,2% проти 63,7% у Typesafe AI’s Jev.
Як агенти використовують це?
Хостинговий сервер MCP не потребує ключа API. Claude Code підключається за допомогою 1 команди:
Скопіювати кодСкопійованоВикористайте інший браузер
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude та Codex також працюють через OAuth. Стандартний агентський режим коштує 0,018 долара за сторінку аналізу.
Агенти, що програмують, можуть встановити навичку document-extraction-api за допомогою npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api.
Чи можна запустити локально?
У додатку для Mac документи залишаються локальними лише з локальною моделлю. Повністю автономний продакшен потребує SDK.
Як воно оцінюється на WholeDoc Bench?
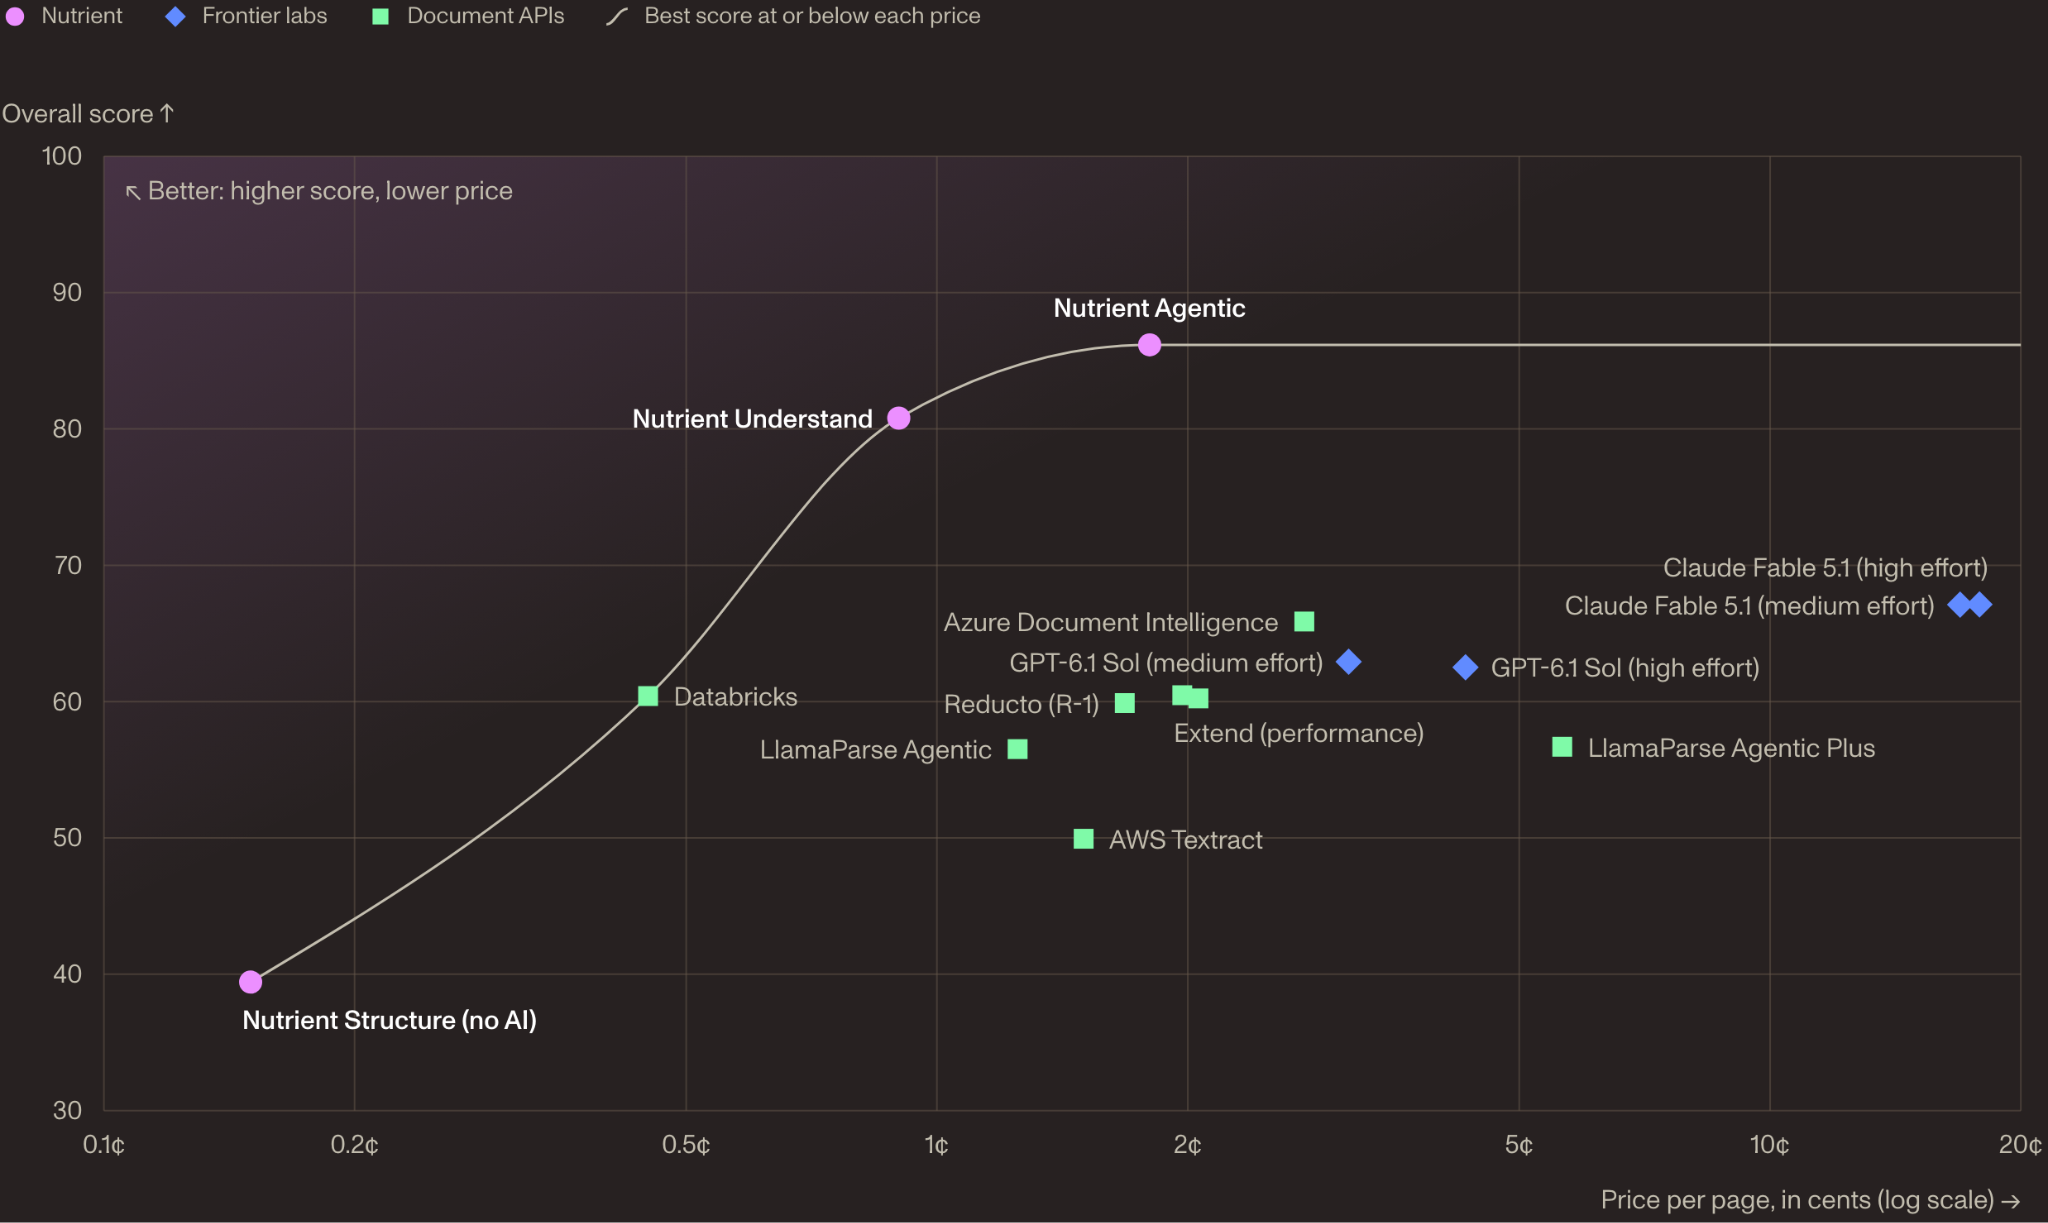
Новий WholeDoc Bench від Nutrient оцінює цілі документи, а не окремі сторінки: 480 документів, понад 30 мов, 7 областей.
| Настройка | Загальний | Таблиці | Діаграми | Позиція | ¢/сторінка |
| Nutrient Agentic | 86.2 | 87.1 | 64.5 | 88.6 | 1.8 |
| Nutrient Understand | 80.8 | 86.1 | 35.1 | 86.4 | 0.9 |
| Claude Fable 5.1 (високі зусилля) | 67.1 | 84.7 | 58.9 | 66.0 | 17.8 |
| Azure Document Intelligence | 65.9 | 69.4 | 0 | 72.5 | ≈2.8 |
| GPT-6.1 Sol (середні зусилля) | 62.9 | 82.8 | 47.6 | 49.3 | ≈3.1 |
| Extend (продуктивність) | 60.5 | 80.8 | 40.6 | 75.2 | 2.0 |
| Reducto (R-1) | 59.9 | 76.4 | 38.5 | 76.4 | ≈1.7 |
| LlamaParse Agentic Plus | 56.7 | 89.5 | 0* | 65.4 | ≈5.6 |
| AWS Textract | 49.9 | 71.4 | 0 | 70.0 | 1.5 |
| Docling | 40.0 | 63.9 | 20.2 | 0 | Локальний |
Вибрані рядки, рейтинг WholeDoc, 5 листопада 2026 року, ціни за списком. *Оцінка все ще перебуває на стадії перевірки.
Найбільший пробіл — це безперервність між сторінками. З 44 документів із таблицями, що охоплюють кілька сторінок, лише 15 із 19 настроек рідко зберігали їх цілими.
Nutrient розробив та запустив цю систему, а основний тестовий набір є приватним. Код надається за ліцензією Apache-2.0, разом із публічною вибіркою з 10 документів.
Основні висновки
- Поля містять сторінки, регіони, мітки збігу та, за наявності, рівень довіри.
- Налаштуйте та протестуйте в Studio перед написанням будь-якого коду API.
- Витрати на екстракцію в режимі Understand становлять 15 доларів за 1 000 сторінок.
- Agentic очолює WholeDoc Bench від Nutrient з результатом 86.2 при вартості 1.8¢ за сторінку.
- Діаграми залишаються складними: 64.5 — найкращий показник для діаграм у WholeDoc.
Дивіться API для екстракції даних, бенчмарки, сервер MCP та навички агентів на GitHub.
Дякуємо команді AI Nutrient за лідерство у галузі та ресурси для цієї статті. Ця стаття спонсорована.
Публікація Nutrient Data Extraction API: JSON-збіг із вашою схемою з цитуванням та рівнем довіри для кожного поля вперше з'явилася на MarkTechPost.