
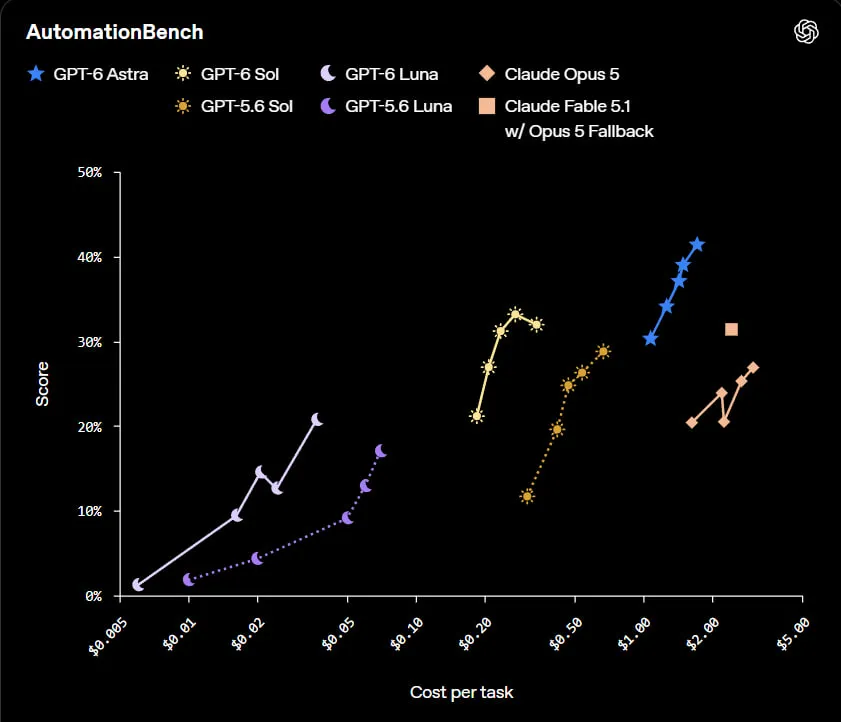
ในการทดสอบงานด้านการทำงาน AutomationBench Sol เหนือกว่า Claude Opus 5 (33.2% ต่อ 26.9%) และ Fable 5.1 (31.4%) โดยการดำเนินงานแต่ละงานมีค่าใช้จ่ายต่ำกว่า Opus 5 ประมาณ 11 เท่า
ในการทดสอบข้อผิดพลาดจริงภายใน โซล มีจำนวนข้อผิดพลาดลดลงถึงครึ่งหนึ่งเมื่อเทียบกับ GPT-5.6 โซลเป็นโมเดลที่มีความน่าเชื่อถือใกล้เคียงกับ Astra ในขณะที่มีราคาถูกกว่า ค่าบริการ API พื้นฐานสำหรับโซลลดลง 50% (2 ดอลลาร์/10 ดอลลาร์ต่อ 1 ล้านโทเคน) ส่วน Luna ลดลง 50-58%
โซลเหมาะสำหรับการเขียนโค้ดที่ซับซ้อนและงานที่เกี่ยวข้องกับเอเจนต์ (พัฒนาฟีเจอร์ ตรวจทานโค้ด ดีบัก วิเคราะห์ข้อมูล) ส่วน Luna เหมาะสำหรับงานที่ง่ายกว่าและเป็นงานในระดับใหญ่ เช่น การสรุปเนื้อหาและการดึงข้อมูล
อ่านบทความนี้ต่อที่แหล่งที่มา: openai.com