
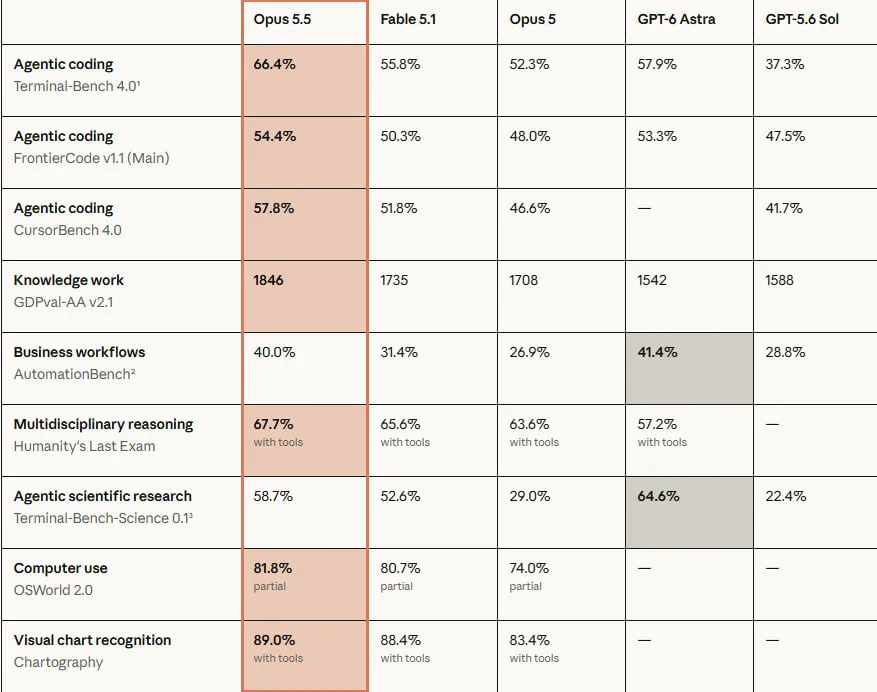
ในด้านประสิทธิภาพ โมเดลนี้ไม่ได้ด้อยกว่า Claude Fable 5.1 ในภารกิจส่วนใหญ่ และมีค่าใช้จ่ายในการดำเนินงานต่ำกว่า Opus 5 ถึง 40%
จากการทดสอบมาตรฐาน โมเดลนี้แซงหน้า GPT-5.6 Sol ใน 6 จาก 6 การทดสอบทั่วไป ส่วน GPT-6 Astra แซงหน้าใน 4 จาก 6 การทดสอบ (การทดสอบอิสระยืนยันอย่างน้อย Terminal-Bench 4.0: 66.4% เทียบกับ 57.9% ของ Astra)
ผู้ใช้งานระบุว่ามีการเพิ่มขึ้นอย่างเห็นได้ชัดในความเร็วเมื่อใช้งานจริง—ตัวอย่างเช่น การตรวจสอบฐานโค้ดขนาด 200,000 บรรทัดใช้เวลาไม่ถึง 3 ชั่วโมง ลดลงจากกว่า 20 ชั่วโมงในรุ่นก่อนหน้า
อ่านบทความนี้ต่อที่แหล่งที่มา: anthropic.com