
LLM นำเสนอค่าที่ผิดพลาดซึ่งดึงจากเอกสารว่าเป็นข้อเท็จจริง ข้อผิดพลาดนั้นมีราคาสูง โดยเฉพาะเมื่อนำไปใช้ประกอบการตัดสินใจ Nutrient Data Extraction API มุ่งแก้ปัญหานั้น โดยสามารถแยกวิเคราะห์ PDF สแกน รูปภาพ และไฟล์ Office ให้เป็น JSON เชิงพื้นที่หรือ Markdown ดึงฟิลด์จากเอกสารไปยังโครงแบบ JSON ของคุณ พร้อมทั้งฟังก์ชันแบ่งแยก จำแนกประเภท และสร้างเอนด์พอยต์ ซึ่งเป็นองค์ประกอบพื้นฐานที่มีประโยชน์สำหรับเวิร์กโฟลว์การประมวลผลเอกสารของคุณ ค่าที่ดึงออกมาแต่ละค่าจะถูกเชื่อมโยงกับหน้าเอกสารผ่านกรอบขอบเขต ป้ายกำกับความตรงกัน และคะแนนความเชื่อมั่น Nutrient (เดิมชื่อ PSPDFKit) ใช้กลไกเดียวกันเบื้องหลัง MCP server ทักษะเอเจนต์ Mac app และ SDK
สรุปสั้น ๆ
- ขนาด: API แบบโฮสต์พร้อมโหมดการแยกวิเคราะห์ 4 แบบ รวมถึงการกำหนดเส้นทางอัตโนมัติ
- ทำงานบน: คลาวด์ของ Nutrient เซิร์ฟเวอร์ของคุณเองผ่าน SDK หรือ Mac ที่ใช้ชิป Apple Silicon
- ทดลองใช้ได้ที่: Studio พื้นที่ทำงานในเบราว์เซอร์สำหรับกำหนดค่าและทดสอบการแยกวิเคราะห์ การดึงข้อมูล การจำแนกประเภท การแบ่งแยก และการกรอกแบบฟอร์ม
- ประสิทธิภาพ: คะแนนโดยรวม 86.2 จาก WholeDoc Bench ของ Nutrient สูงสุดใน 19 การตั้งค่า (API สด, Agentic)
- ดีที่สุด: 86.2 ในราคา 1.8¢ ต่อหน้า เทียบกับ 67.1 ในราคา 17.8¢ สำหรับการตั้งค่าโมเดลแนวหน้าที่ดีที่สุด
จะทดสอบใน Studio ก่อนเขียนโค้ดได้อย่างไร?
Studio คือพื้นที่ทำงานในเบราว์เซอร์ของ Nutrient สำหรับกำหนดค่าและทดสอบ API ก่อนนำไปผสานรวมในแอปพลิเคชันของคุณ โดยสามารถ ทดสอบการแยกวิเคราะห์ การดึงข้อมูล การจำแนกประเภท การแบ่งแยก และการกรอกแบบฟอร์มบนไฟล์ของคุณเอง ขั้นตอนทั่วไปมีดังนี้:
- อัปโหลดเอกสารตัวอย่างและตั้งค่าพารามิเตอร์ที่คุณวางแผนจะส่ง
- ร่างโครงแบบใน UI หรือ สร้างโครงแบบ จากเอกสารของคุณเอง
- รันบนเอกสารใหม่ จากนั้นตรวจสอบค่าและแหล่งอ้างอิง
- บันทึกการตั้งค่าเป็นพรีเซตที่มีเวอร์ชัน ซึ่ง API เรียกว่า processor พร้อม ID โปรเซสเซอร์
- ประเมินเวอร์ชันพรีเซตโดยเปรียบเทียบกับเอกสารที่ผ่านการตรวจสอบแล้วสูงสุด 25 รายการในชุดประเมิน
โปรเซสเซอร์ที่บันทึกไว้ใน Studio สามารถเรียกใช้ผ่าน API ได้โดยใช้ ID
ควรเลือกโหมดใด?
Auto จะกำหนดเส้นทางแต่ละหน้าไปยัง structure, understand หรือ agentic หากไม่ระบุโหมด API จะตั้งค่าเริ่มต้นเป็น understand
| การดำเนินการ | เหมาะสำหรับ | ราคาต่อหน้า | การดึงข้อมูลต่อหน้า | WholeDoc Bench* |
| แยกวิเคราะห์: ข้อความ | PDF และไฟล์ Office ที่สร้างขึ้นในระบบดิจิทัล ไม่ต้องใช้ OCR | $0.001 | $0.007** | ยังไม่ได้ทดสอบ |
| แยกวิเคราะห์: structure | OCR สำหรับสแกนที่มีเลย์เอาต์เรียบง่าย ไม่ต้องใช้ AI | $0.0015 | $0.0075 | 39.4 |
| แยกวิเคราะห์: understand | AI วิเคราะห์เลย์เอาต์: แบบฟอร์ม เลย์เอาต์ซับซ้อน | $0.009 | $0.015 | 80.8 |
| แยกวิเคราะห์: agentic | Vision language model: ลายมือ ภาพสแกนที่เสื่อมสภาพ แผนภูมิ | $0.018 | $0.024 | 86.2 |
| จำแนกประเภท | ป้ายกำกับเอกสารแบบ Zero-shot | $0.001 | n/a | n/a |
| แบ่งแยก | แยก PDF ที่รวมกันเป็นเอกสารต่าง ๆ | $0.003 | n/a | n/a |
*WholeDoc Bench คะแนนการแยกวิเคราะห์ ณ วันที่ 5 พฤศจิกายน 2026; ไม่ใช่ความแม่นยำในการดึงข้อมูล การดึงข้อมูลเพิ่ม $0.006 ต่อหน้า **เอกสาร API ระบุว่าโหมดข้อความดึงข้อมูลได้; ทักษะเอเจนต์เริ่มต้นที่ structure
ราคาอยู่ในสกุลดอลลาร์สหรัฐ โดยเริ่มต้นจากยอดคงเหลือ 1 หน่วยที่แชร์ร่วมกันผ่าน API คลาวด์ของ Nutrient ทำให้ทีมสามารถผสมผสานและปรับแต่งได้ แผนฟรีมอบโควตาการใช้งานรายเดือน 5 ดอลลาร์ ซึ่งครอบคลุมการดึงข้อมูลในโหมดเข้าใจประมาณ 330 รายการ ส่วนแผน Starter ราคา 75 ดอลลาร์ต่อเดือน มีโควตา 90 ดอลลาร์; แผน Growth ราคา 275 ดอลลาร์ มีโควตา 345 ดอลลาร์
ความเชื่อมั่นที่มีพื้นฐานทำงานอย่างไร?
ใน โพสต์เกี่ยวกับความเชื่อมั่น ของ Nutrient พบว่าฟิลด์หนึ่งได้คะแนน 0.97 แต่กลับมาจากคอลัมน์ผิด
คะแนนปัจจุบันเป็น ค่ารวม ของสัญญาณทางเลือก: ความน่าจะเป็นของโทเค็น ระยะขอบผู้สมัคร การเชื่อมโยงข้อมูลและรูปแบบ โมเดลการเชื่อมโยงข้อมูล NLI ของ Nutrient เปิดให้ใช้งานภายใต้ Apache-2.0 แม้ว่าค่าที่เชื่อมโยงข้อมูลแล้วจะยังสามารถตอบคำถามในฟิลด์ที่ไม่ถูกต้องได้ เมื่อไม่มีคะแนน ความเชื่อมั่นจะถูกละเว้น ไม่ได้หมายความว่าต่ำ
แต่ละฟิลด์ยังมีป้ายกำกับการจับคู่: id_match, id_match_multiblock, id_match_partial, fuzzy_match หรือ not_found ควรตรวจสอบป้ายกำกับก่อน แล้วจึงพิจารณาความเชื่อมั่น
คัดลอกโค้ดคัดลอกแล้วใช้เบราว์เซอร์อื่น
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "หมายเลขใบแจ้งหนี้ใต้รายละเอียดซัพพลายเออร์."},
        "total_amount": {"type": "number", "description": "ยอดรวมสุดท้ายที่พิมพ์รวมภาษี ไม่ใช่ยอดรวมย่อย."},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # ใช้เพื่อแสดงภาพเท่านั้น; ประเมินจากเอกสารตัวแทน

for field in schema["properties"]:  # วนรอบฟิลด์ที่คาดหวังเพื่อให้แน่ใจว่าทุกฟิลด์ได้รับการตรวจสอบ
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = ไม่มีคะแนน
    passes = (value is not None and match in EXACT
              and conf is not None and conf >= THRESHOLD)
    print(field, value, match, conf, "page", meta.get("pageNumber"),
          "PASSES_BASIC_CHECKS" if passes else "REVIEW")
ตัวอย่างนี้ครอบคลุมเฉพาะโครงสร้างข้อมูลแบบแบน; ในสภาพแวดล้อมจริงจำเป็นต้องมีการตรวจสอบประเภทข้อมูลและกฎทางธุรกิจ ค่ามาตรฐาน 0.97 เหมือนกับฟิลด์เงินใน บทแนะนำการจำนอง ของ Nutrient
การจำแนกประเภทและการแยกข้อมูลทำงานอย่างไร?
โมเดลการตัดสินใจเอกสาร ขับเคลื่อนการ จำแนกประเภท และ การแยกข้อมูล Nutrient รายงานค่า F1 ของการแยกข้อมูลอยู่ที่ 96.2% เทียบกับ 63.7% ของ Jev จาก Typesafe AI
ตัวแทนใช้งานอย่างไร?
เซิร์ฟเวอร์ MCP ที่โฮสต์ไม่จำเป็นต้องใช้คีย์ API Claude Code เชื่อมต่อด้วยคำสั่งเดียว:
คัดลอกโค้ดคัดลอกแล้วใช้เบราว์เซอร์อื่น
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude และ Codex ยังรองรับการทำงานผ่าน OAuth โหมดตัวแทนเริ่มต้นมีค่าใช้จ่าย 0.018 ดอลลาร์ต่อหน้าสำหรับการประมวลผล
ตัวแทนเขียนโค้ดสามารถติดตั้ง ทักษะ document-extraction-api ได้โดยใช้ npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api
สามารถรันแบบออฟไลน์ได้หรือไม่?
บนแอป Mac เอกสารจะถูกเก็บไว้ในเครื่องเท่านั้นเมื่อใช้โมเดลแบบออฟไลน์ หากต้องการใช้งานแบบออฟไลน์เต็มรูปแบบจำเป็นต้องใช้ SDK
มีประสิทธิภาพอย่างไรใน WholeDoc Bench?
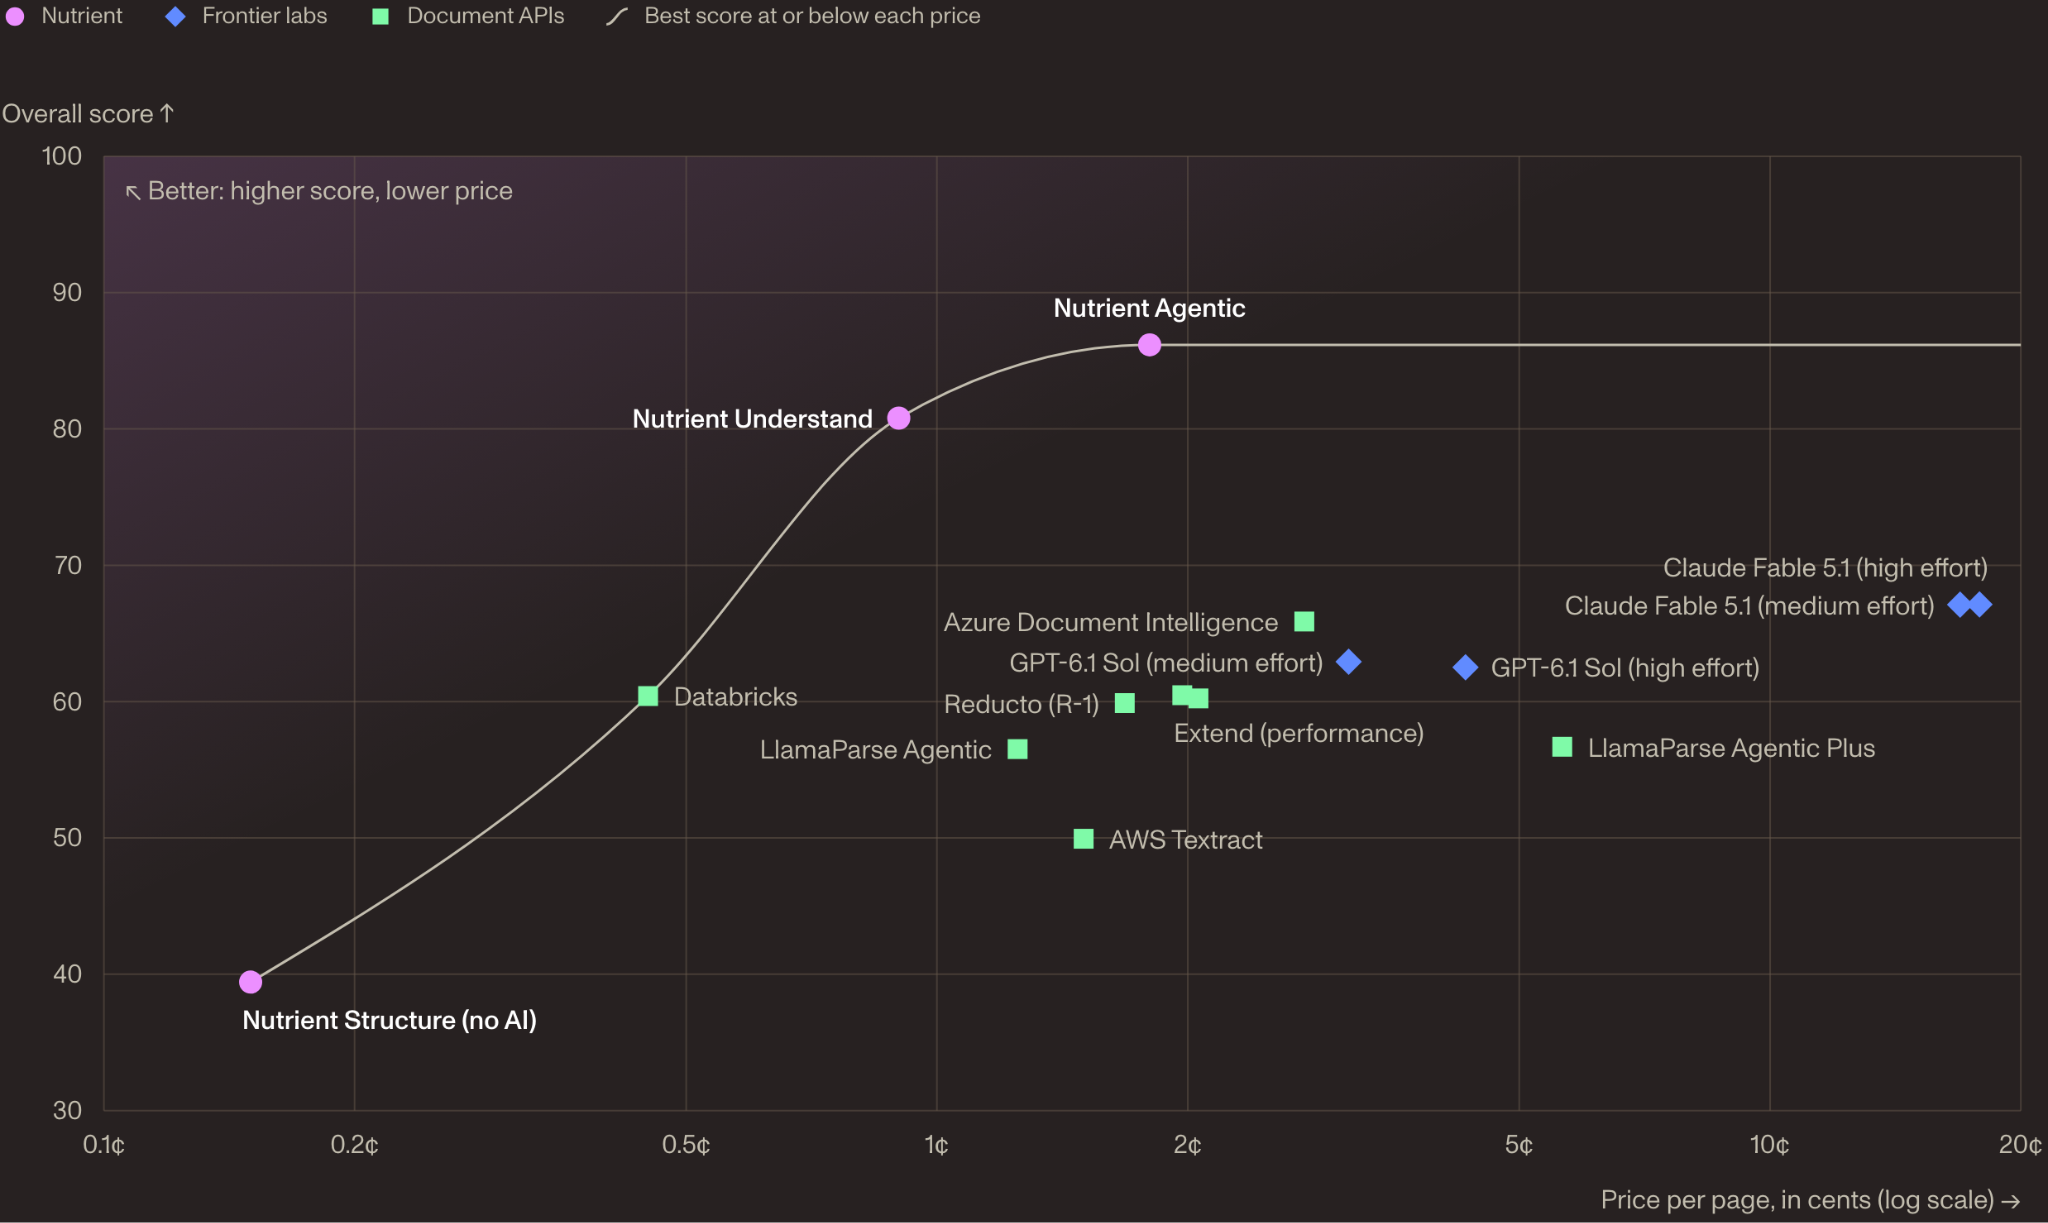
< a href="22">WholeDoc Bench ใหม่ของ Nutrient ให้คะแนนเอกสารทั้งฉบับ ไม่ใช่เพียงหน้าเดียว: เอกสาร 480 ฉบับ, กว่า 30 ภาษา, 7 ด้าน (เวิลด์ด็อก เบนช์)
| การตั้งค่า | โดยรวม | ตาราง | แผนภูมิ | ตำแหน่ง | ¢/หน้า |
| Nutrient Agentic | 86.2 | 87.1 | 64.5 | 88.6 | 1.8 |
| Nutrient Understand | 80.8 | 86.1 | 35.1 | 86.4 | 0.9 |
| Claude Fable 5.1 (ความพยายามสูง) | 67.1 | 84.7 | 58.9 | 66.0 | 17.8 |
| Azure Document Intelligence | 65.9 | 69.4 | 0 | 72.5 | ≈2.8 |
| GPT-6.1 Sol (ความพยายามปานกลาง) | 62.9 | 82.8 | 47.6 | 49.3 | ≈3.1 |
| Extend (ประสิทธิภาพ) | 60.5 | 80.8 | 40.6 | 75.2 | 2.0 |
| Reducto (R-1) | 59.9 | 76.4 | 38.5 | 76.4 | ≈1.7 |
| LlamaParse Agentic Plus | 56.7 | 89.5 | 0* | 65.4 | ≈5.6 |
| AWS Textract | 49.9 | 71.4 | 0 | 70.0 | 1.5 |
| Docling | 40.0 | 63.9 | 20.2 | 0 | Local |
แถวที่เลือก, Leaderboard WholeDoc, 5 พฤศจิกายน 2026, ราคาตามรายการ. *คะแนนยังอยู่ระหว่างการตรวจสอบ.
ความต่อเนื่องข้ามหน้าเป็นช่องว่างที่ใหญ่ที่สุด ในเอกสาร 44 ฉบับที่มีตารางข้ามหน้า การตั้งค่า 15 จาก 19 แบบแทบไม่สามารถเก็บตารางไว้ได้ครบถ้วน
Nutrient เป็นผู้สร้างและดำเนินการทดสอบ โดยชุดทดสอบหลักเป็นแบบส่วนตัว โค้ด ใช้สัญญาอนุญาต Apache-2.0 พร้อมตัวอย่างสาธารณะ 10 เอกสาร
ข้อสำคัญที่ควรทราบ
- ฟิลด์ประกอบด้วยหน้า, บริเวณ, ป้ายกำกับการจับคู่ และหากมี ค่าความเชื่อมั่น
- กำหนดค่าและทดสอบใน Studio ก่อนเขียนโค้ด API ใดๆ
- การดึงข้อมูลในโหมด Understand มีค่าใช้จ่าย $15 ต่อ 1,000 หน้า
- Agentic นำโด่ง WholeDoc Bench ของ Nutrient ด้วยคะแนน 86.2 คิดค่าใช้จ่าย 1.8¢ ต่อหน้า
- แผนภูมิยังคงเป็นเรื่องยาก: 64.5 คือคะแนนแผนภูมิ WholeDoc ที่ดีที่สุด
โปรดดู Data Extraction API, เกณฑ์มาตรฐาน, เซิร์ฟเวอร์ MCP และ ทักษะเอเจนต์บน GitHub
ขอบคุณทีม AI ของ Nutrient สำหรับความเป็นผู้นำทางความคิด / ทรัพยากรที่สนับสนุนบทความนี้ บทความนี้ได้รับการสนับสนุน
โพสต์ Nutrient Data Extraction API: JSON Matching Your Schema With Per-Field Citations and Confidence ปรากฏครั้งแรกบน MarkTechPost.