
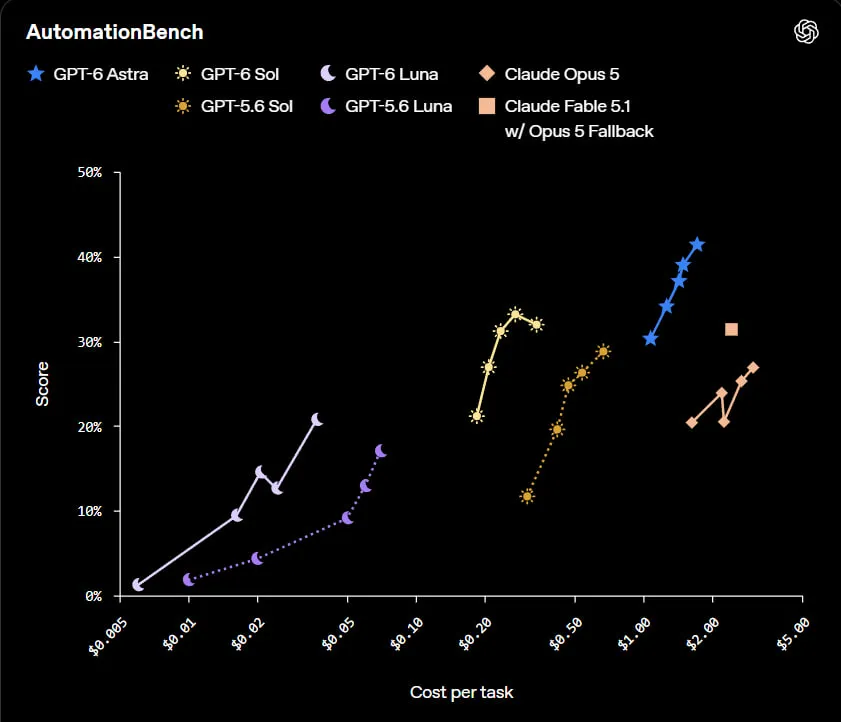
No teste de tarefas práticas, o AutomationBench Sol supera o Claude Opus 5 (33,2% contra 26,9%) e o Fable 5.1 (31,4%) — ao mesmo tempo, a execução da tarefa custa cerca de 11 vezes menos do que o Opus 5.
No teste interno de erros reais, o Sol apresentou metade dos erros em comparação com o GPT-5.6. A modelo está se aproximando da confiabilidade do Astra, com um preço mais baixo. As tarifas básicas da API para o Sol foram reduzidas em 50% ($2/$10 por milhão de tokens), e para o Luna, entre 50% e 58%.
Sol — para codificação complexa e tarefas agentes (desenvolvimento de recursos, revisão de código, depuração, análise de dados); Luna — para tarefas mais simples e massivas, como resumo e extração de dados.
Continue lendo este artigo na fonte: openai.com