
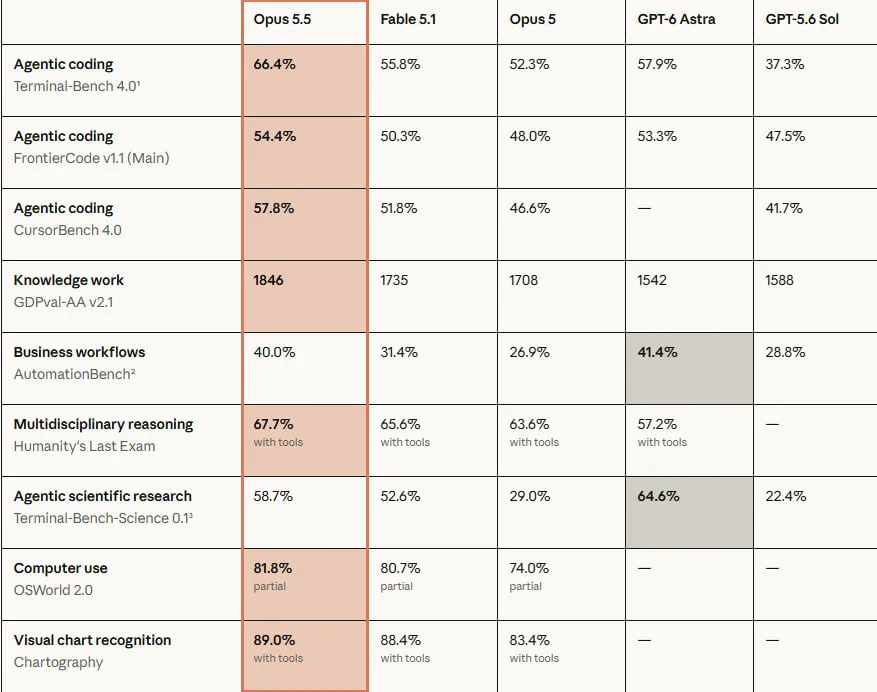
Em termos de desempenho, ela não fica atrás do Claude Fable 5.1 na maioria das tarefas e custa 40% menos para operar do que o Opus 5.
Nos benchmarks, na versão lançada, a modelo supera o GPT-5.6 Sol em 6 dos 6 testes gerais, e o GPT-6 Astra em 4 dos 6 (testes independentes confirmam pelo menos o Terminal-Bench 4.0: 66,4% contra 57,9% do Astra)
Os usuários observam um aumento significativo na velocidade em tarefas reais — por exemplo, a auditoria de uma base de código de 200 mil linhas levou menos de 3 horas, contra mais de 20 horas na versão anterior.
Continue lendo este artigo na fonte: anthropic.com