
Um LLM apresenta a você um valor incorreto extraído de um documento como fato. Esse erro é custoso, especialmente ao basear decisões nele. A Nutrient Data Extraction API visa resolver esse problema. Ela analisa PDFs, digitalizações, imagens e arquivos do Office, convertendo-os em JSON espacial ou Markdown. Extraia campos de documentos para o seu esquema JSON, e operações de divisão, classificação e preenchimento de formulários fornecem primitivas úteis para seus pipelines de documentos. Cada valor extraído é vinculado a uma página por meio de uma caixa delimitadora, um rótulo correspondente e uma pontuação de confiança. Nutrient (anteriormente PSPDFKit) executa o mesmo motor por trás de um servidor MCP, habilidade agente, aplicativo para Mac e SDK.
TL;DR
- Tamanho: Uma API hospedada com 4 modos de análise mais roteamento automático.
- Execução em: Nuvem Nutrient, seus próprios servidores via SDK ou um Mac com chip Apple Silicon.
- Onde experimentar: Studio, um espaço de trabalho no navegador para configurar e testar análise, extração, classificação, divisão e preenchimento de formulários.
- Desempenho: 86,2 no geral no WholeDoc Bench da Nutrient, melhor entre 19 configurações (API ao vivo, Agentic).
- Melhor: 86,2 a 1,8¢ por página, contra 67,1 a 17,8¢ na melhor configuração de modelo de fronteira.
Como testá-la no Studio antes de escrever código?
Studio é o espaço de trabalho no navegador da Nutrient para configurar e testar a API antes de integrá-la ao seu aplicativo. Ele permite testar análise, extração, classificação, divisão e preenchimento de formulários em seus próprios arquivos. Um ciclo típico:
- Envie um documento de exemplo e defina os parâmetros que planeja enviar.
- Crie um esquema na interface do usuário ou gere um com base nos seus próprios documentos.
- Execute-o em um novo documento e inspecione os valores e as citações.
- Salve a configuração como uma predefinição versionada. A API chama isso de processador, com um ID de proc.
- Avalie versões da predefinição com até 25 documentos revisados em um conjunto de avaliação.
Os processadores salvos no Studio podem então ser chamados pela API pelo ID.
Qual modo escolher?
Auto direciona cada página para estrutura, compreensão ou agente. Se o modo for omitido, a API usa compreensão por padrão.
| Operação | Melhor para | Preço por página | Extração por página | WholeDoc Bench* |
| Análise: texto | PDFs e arquivos do Office nativos digitais, sem OCR | $0,001 | $0,007** | Não testado |
| Análise: estrutura | OCR para digitalizações com layouts simples, sem IA | $0,0015 | $0,0075 | 39,4 |
| Análise: compreensão | Análise de layout por IA: formulários, layouts complexos | $0,009 | $0,015 | 80,8 |
| Análise: agente | Modelo de linguagem visual: caligrafia cursiva, digitalizações degradadas, gráficos | $0,018 | $0,024 | 86,2 |
| Classificação | Rótulos de documentos zero-shot | $0,001 | n/a | n/a |
| Divisão | Separar PDFs mesclados em documentos | $0,003 | n/a | n/a |
*Pontuação de análise do WholeDoc Bench, 5 de novembro de 2026; não é precisão de extração. A extração adiciona $0,006 por página. **A documentação da API lista extração no modo texto; a habilidade agente começa em estrutura.
Os preços estão em dólares, a partir de 1 saldo compartilhado pelas APIs em nuvem da Nutrient, permitindo que as equipes misturem e combinem. O plano gratuito oferece $5 de uso mensal, cobrindo cerca de 330 extrações no modo de compreensão. O Starter custa $75 por mês para $90 de uso; o Growth custa $275 para $345.
Como funciona a confiança fundamentada?
No post de confiança da Nutrient, um campo recebeu pontuação 0,97, mas veio da coluna errada.
A pontuação atual é uma composição de sinais opcionais: probabilidade do token, margem do candidato, fundamentação e formato. O modelo de fundamentação de NLI da Nutrient está aberto sob Apache-2.0. Um valor fundamentado ainda pode responder ao campo errado. Quando não há pontuação, a confiança é omitida, não considerada baixa.
Cada campo também recebe um rótulo de correspondência: id_match, id_match_multiblock, id_match_partial, fuzzy_match ou not_found. Verifique primeiro o rótulo e depois a confiança.
Copiar CódigoCopiadoUse um Navegador Diferente
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "Número da fatura abaixo dos detalhes do fornecedor."},
        "total_amount": {"type": "number", "description": "Total final impresso incluindo impostos. Não é o subtotal."},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # apenas ilustrativo; avalie em documentos representativos

for field in schema["properties"]:  # iteração sobre campos esperados para evitar revisão
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = sem pontuação
    passes = (value is not None e match em EXACT
              e conf is not None e conf >= THRESHOLD)
    print(field, value, match, conf, "página", meta.get("pageNumber"),
          "APROVADO_NAS_VERIFICAÇÕES_BÁSICAS" se passes else "REVISÃO")
Esta demonstração cobre apenas esquemas planos; a produção requer verificações de tipo e de regras de negócio. A barra de 0,97 reflete os campos monetários no tutorial de hipotecas da Nutrient.
Como funcionam classify e split?
Um modelo de decisão de documento alimenta classify e split. A Nutrient reporta F1 de split de 96,2% contra 63,7% da Jev da Typesafe AI.
Como os agentes o utilizam?
O servidor MCP hospedado não precisa de chave API. Claude Code conecta-se com 1 comando:
Copiar CódigoCopiadoUse um Navegador Diferente
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude e Codex também funcionam via OAuth. O modo agêntico padrão custa $0,018 por página para análise.
Agentes de codificação podem instalar a habilidade document-extraction-api com npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api.
Pode ser executado localmente?
No aplicativo para Mac, os documentos permanecem locais apenas com um modelo local. A produção totalmente offline requer o SDK.
Como ele se sai no WholeDoc Bench?
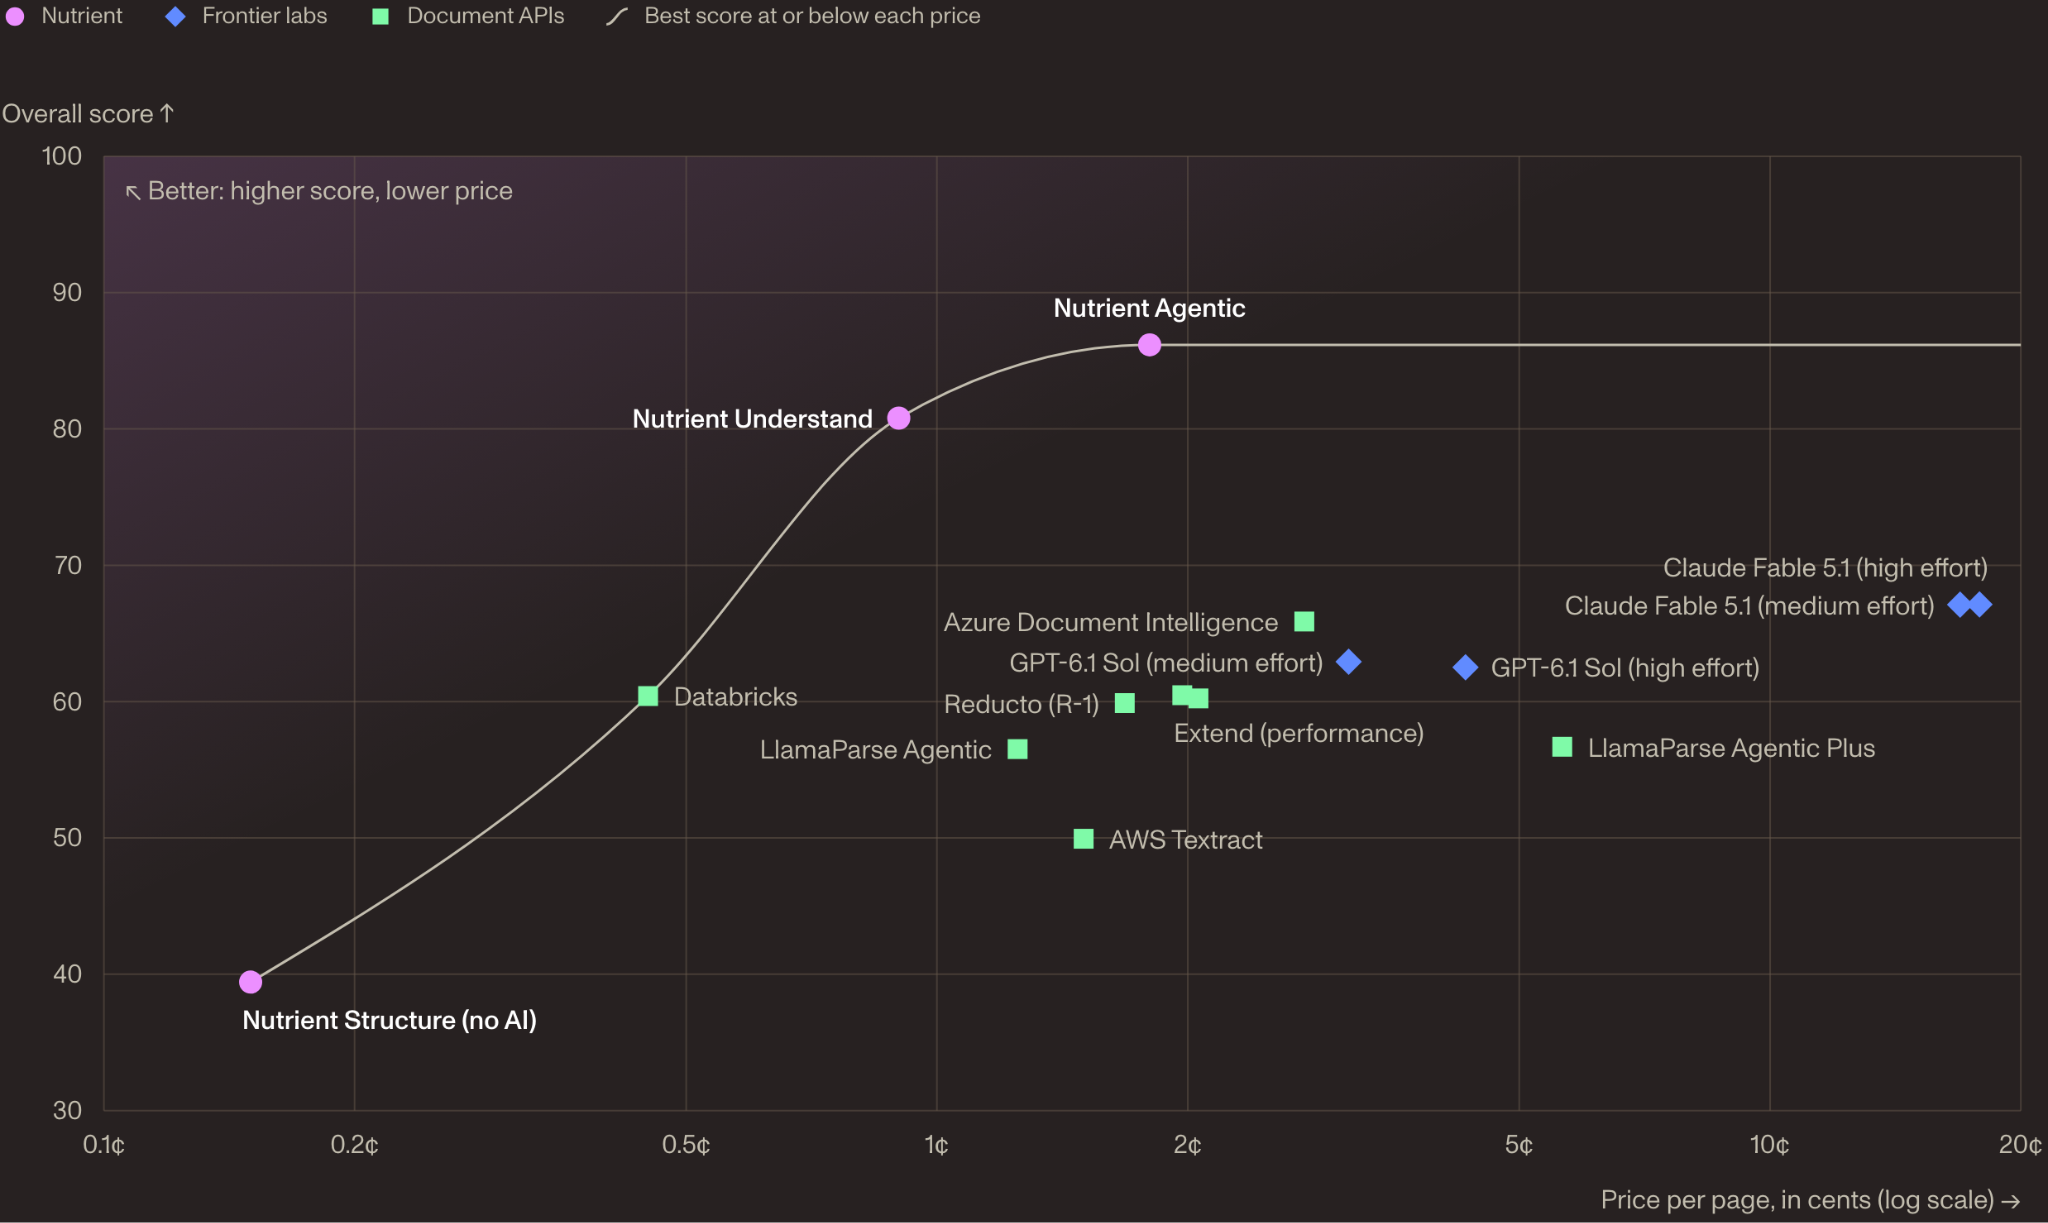
O novo WholeDoc Bench da Nutrient avalia documentos inteiros, não apenas páginas individuais: 480 documentos, mais de 30 idiomas, 7 áreas.
| Configuração | Geral | Tabelas | Gráficos | Posição | ¢/página |
| Nutrient Agentic | 86,2 | 87,1 | 64,5 | 88,6 | 1,8 |
| Nutrient Understand | 80,8 | 86,1 | 35,1 | 86,4 | 0,9 |
| Claude Fable 5.1 (alto esforço) | 67,1 | 84,7 | 58,9 | 66,0 | 17,8 |
| Azure Document Intelligence | 65,9 | 69,4 | 0 | 72,5 | ≈2,8 |
| GPT-6.1 Sol (esforço médio) | 62,9 | 82,8 | 47,6 | 49,3 | ≈3,1 |
| Extend (desempenho) | 60,5 | 80,8 | 40,6 | 75,2 | 2,0 |
| Reducto (R-1) | 59,9 | 76,4 | 38,5 | 76,4 | ≈1,7 |
| LlamaParse Agentic Plus | 56,7 | 89,5 | 0* | 65,4 | ≈5,6 |
| AWS Textract | 49,9 | 71,4 | 0 | 70,0 | 1,5 |
| Docling | 40,0 | 63,9 | 20,2 | 0 | Local |
Linhas selecionadas, classificação WholeDoc, 5 de novembro de 2026, preços de tabela. *Pontuação ainda em revisão.
A continuidade entre páginas é a maior lacuna. Em 44 documentos com tabelas que abrangem várias páginas, 15 das 19 configurações raramente as mantiveram inteiras.
A Nutrient desenvolveu e executou o benchmark, e o conjunto principal de testes é privado. O código está sob licença Apache-2.0, com uma amostra pública de 10 documentos.
Principais Conclusões
- Os campos contêm páginas, regiões, rótulos de correspondência e, quando disponíveis, confiança.
- Configure e teste no Studio antes de escrever qualquer código de API.
- A extração no modo Understand custa US$ 15 por 1.000 páginas.
- O Agentic lidera o WholeDoc Bench da Nutrient com 86,2, a 1,8¢ por página.
- Gráficos continuam difíceis: 64,5 é a melhor pontuação WholeDoc para gráficos.
Consulte a API de Extração de Dados, os benchmarks, o servidor MCP e as habilidades do agente no GitHub.
Agradecemos à equipe de IA da Nutrient pela liderança conceitual e pelos recursos fornecidos para este artigo. Este artigo é patrocinado.
A publicação Nutrient Data Extraction API: JSON Matching Your Schema With Per-Field Citations and Confidence foi publicada originalmente em MarkTechPost.