
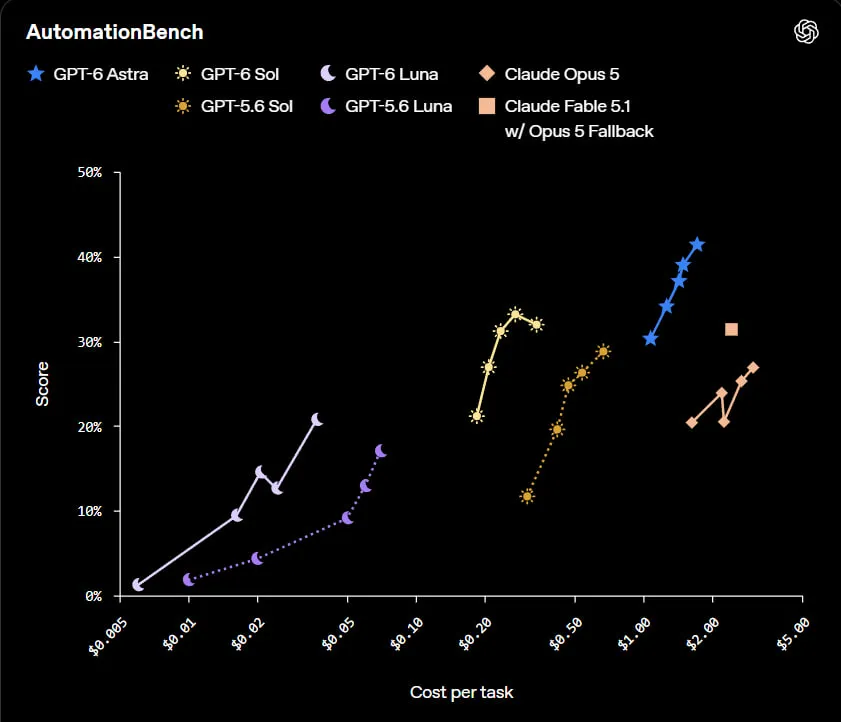
W teście zadań roboczych AutomationBench Sol wyprzedza Claude Opus 5 (33,2% w porównaniu z 26,9%) i Fable 5.1 (31,4%) – przy tym wykonanie zadania jest około 11 razy tańsze niż u Opus 5.
W wewnętrznym teście błędów rzeczywistych liczba błędów u Sol zmniejszyła się dwukrotnie w porównaniu z GPT-5.6. Model Sol zbliża się pod względem niezawodności do Astra przy niższej cenie. Podstawowe stawki API dla Sol zostały obniżone o 50% ($2/$10 za milion tokenów), a dla Luna – o 50–58%.
Sol – przeznaczony do skomplikowanego kodowania i zadań agentowych (rozwoju funkcji, recenzji kodu, debugowania, analizy danych); Luna – do prostszych i bardziej powszechnych zadań takich jak sumaryzacja i ekstrakcja danych.
Kontynuuj czytanie tego artykułu w źródle: openai.com