
LLM podaje wam błędna wartość wyodrębnioną z dokumentu jako fakt. Ten błąd jest kosztowny, zwłaszcza gdy opieramy na nim decyzje. Nutrient Data Extraction API skierowane jest właśnie do tego problemu. Parsuje pliki PDF, skany, obrazy i pliki Office do formatu spatial JSON lub Markdown. Wyciąga pola mapowe z dokumentu zgodnie ze schematem JSON, a funkcje rozdzielania, klasyfikacji i tworzenia formularzy dostarczają przydatnych prymitywów dla waszych przepływów dokumentów. Każda wyodrębniona wartość jest powiązana z daną stroną za pomocą ramki ograniczającej, etykiety dopasowania i wyniku pewności. Nutrient (wcześniej PSPDFKit) wykorzystuje ten sam silnik zarówno w serwerze MCP, umiejętności agenta, aplikacji Mac jak i SDK.
TL;DR
- Rozmiar: Hostowany API z 4 trybami parsowania plus automatyczne routowanie.
- Działa na: Chmurze Nutrient, własnych serwerach przez SDK lub Macu z procesorem Apple Silicon.
- Gdzie spróbować: Studio, przeglądarkowa przestrzeń robocza do konfiguracji i testowania parsowania, ekstrakcji, klasyfikacji, rozdzielania oraz wypełniania formularzy.
- Wydajność: 86,2 ogólnie w WholeDoc Bench Nutrient, najlepszy spośród 19 ustawień (API na żywo, Agentic).
- Najlepsze: 86,2 przy 1,8¢ za stronę, w porównaniu z 67,1 przy 17,8¢ dla najlepszego ustawienia modelu frontier.
Jak przetestować to w Studio przed napisaniem kodu?
Studio to przeglądarkowa przestrzeń robocza Nutrient do konfiguracji i testowania API przed integracją z aplikacją. Pozwala ono testować parsowanie, ekstrakcję, klasyfikację, rozdzielanie oraz wypełnianie formularzy na własnych plikach. Typowy cykl:
- Prześlij próbny dokument i ustal parametry, które zamierzasz wysłać.
- Stwórz schemat w interfejsie użytkownika lub wygeneruj go na podstawie własnych dokumentów.
- Uruchom to na świeżym dokumencie, następnie sprawdź wartości i cytaty.
- Zapisz konfigurację jako wersję predefinicji. API nazywa ją procesorem z identyfikatorem proc_.
- Oceniaj wersje predefinicji na podstawie maksymalnie 25 przeanalizowanych dokumentów w zestawie ewaluacyjnym.
Procesory zapisane w Studio mogą być następnie wywoływane z API po ID.
Który tryb wybrać?
Auto kieruje każdą stronę do trybu structure, understand lub agentic. Jeśli tryb zostanie pominięty, API domyślnie wybiera understand.
| Operacja | Najlepsze dla | Cena za stronę | Ekstrakcja na stronę | WholeDoc Bench* |
| Parsowanie: tekst | Dokumenty PDF i pliki Office powstałe cyfrowo, bez OCR | 0,001$ | 0,007$** | Nie testowane |
| Parsowanie: structure | OCR dla skanów o prostych układach, bez AI | 0,0015$ | 0,0075$ | 39,4 |
| Parsowanie: understand | Analiza układu za pomocą AI: formularze, złożone layouty | 0,009$ | 0,015$ | 80,8 |
| Parsowanie: agentic | Model języka wizualnego: pismo kursywą, zniszczone skany, wykresy | 0,018$ | 0,024$ | 86,2 |
| Klasyfikacja | Etuike dokumentów zero-shot | 0,001$ | n/a | n/a |
| Rozdzielanie | Oddzielanie połączonych plików PDF na osobne dokumenty | 0,003$ | n/a | n/a |
*Wynik parsowania w WholeDoc Bench, 5 listopada 2026 r.; nie dokładność ekstrakcji. Ekstrakcja dodaje 0,006$ za stronę. **Dokumentacja API wymienia ekstrakcję w trybie tekstowym; umiejętności agenta zaczynają się od trybu structure.
Ceny podano w dolarach, przy czym jedno saldo jest udostępniane przez interfejsy API chmury Nutrient, co pozwala zespołom na dowolne kombinacje. Plan darmowy zapewnia miesięczny limit $5, wystarczający do około 330 operacji wyodrębniania w trybie rozumienia. Starter kosztuje $75 miesięcznie za $90 zużycia; Growth kosztuje $275 za $345.
Jak działa podstawiona pewność?
W wpisie o pewności Nutrient, pole o ocenie 0,97 pochodziło z niewłaściwego kolumny.
Aktualny wynik jest kompozycją opcjonalnych sygnałów: prawdopodobieństwa tokenu, marginesu kandydata, uzasadnienia i formatu. Model uzasadniania NLI Nutrient jest dostępny na licencji Apache-2.0. Wartość uzasadniona może nadal odpowiadać na nieprawidłowe pole. Gdy brak wyniku, poziom pewności jest pomijany, a nie uznawany za niski.
Każde pole otrzymuje również etykietę dopasowania: id_match, id_match_multiblock, id_match_partial, fuzzy_match lub not_found. Najpierw sprawdź etykietę, a następnie wartość pewności.
Kopiuj kodSkopiowanoUżyj innego przeglądarki
import json, requests

API_KEY = "twoje_klucz_api"
schema = {
    "type": "object",
    "properties": {
        "numer_faktury": {"type": "string", "description": "Numer faktury pod informacjami o dostawcy."},
        "suma_razem": {"type": "number", "description": "Drukowana suma końcowa包含podatek. Nie subtotal."},
    },
    "required": ["numer_faktury", "suma_razem"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("faktura.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("faktura.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # tylko ilustracyjnie; należy ocenić na reprezentatywnych dokumentach

for field in schema["properties"]:  # przejdź przez oczekiwane pola, aby żadne nie ominęło kontroli
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = brak oceny
    spełnia warunki: (value nie jest None i match znajduje się w EXACT
              oraz conf nie jest None i conf >= THRESHOLD)
    print(field, value, match, conf, "strona", meta.get("pageNumber"),
          "PASSES_BASIC_CHECKS" jeśli spełnia warunki, w przeciwnym razie "REVIEW")
To demo obejmuje tylko płaskie schematy; produkcja wymaga sprawdzania typów i reguł biznesowych. Bariera 0,97 odzwierciedla pola pieniężne w tutorialu hipotecznym Nutrient.
Jak działają classify i split?
Model decyzyjny dokumentów napędza funkcje classify i split. Nutrient raportuje F1 dla split na poziomie 96,2% w porównaniu z 63,7% dla Jev firmy Typesafe AI.
Jak korzystają z niego agenci?
Hostowany serwer MCP nie wymaga klucza API. Claude Code łączy się za pomocą jednego polecenia:
Kopiuj kodSkopiowanoUżyj innego przeglądarki
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude i Codex współpracują również poprzez OAuth. Domyślny tryb agentyka kosztuje $0,018 za stronę do analizy.
Agenci programujący mogą zainstalować umiejętność document-extraction-api za pomocą polecenia npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api.
Czy można uruchomić to lokalnie?
W aplikacji na Macu dokumenty pozostają lokalne wyłącznie przy użyciu lokalnego modelu. Pełna offline produkcja wymaga SDK.
Jak oceniany jest w WholeDoc Bench?
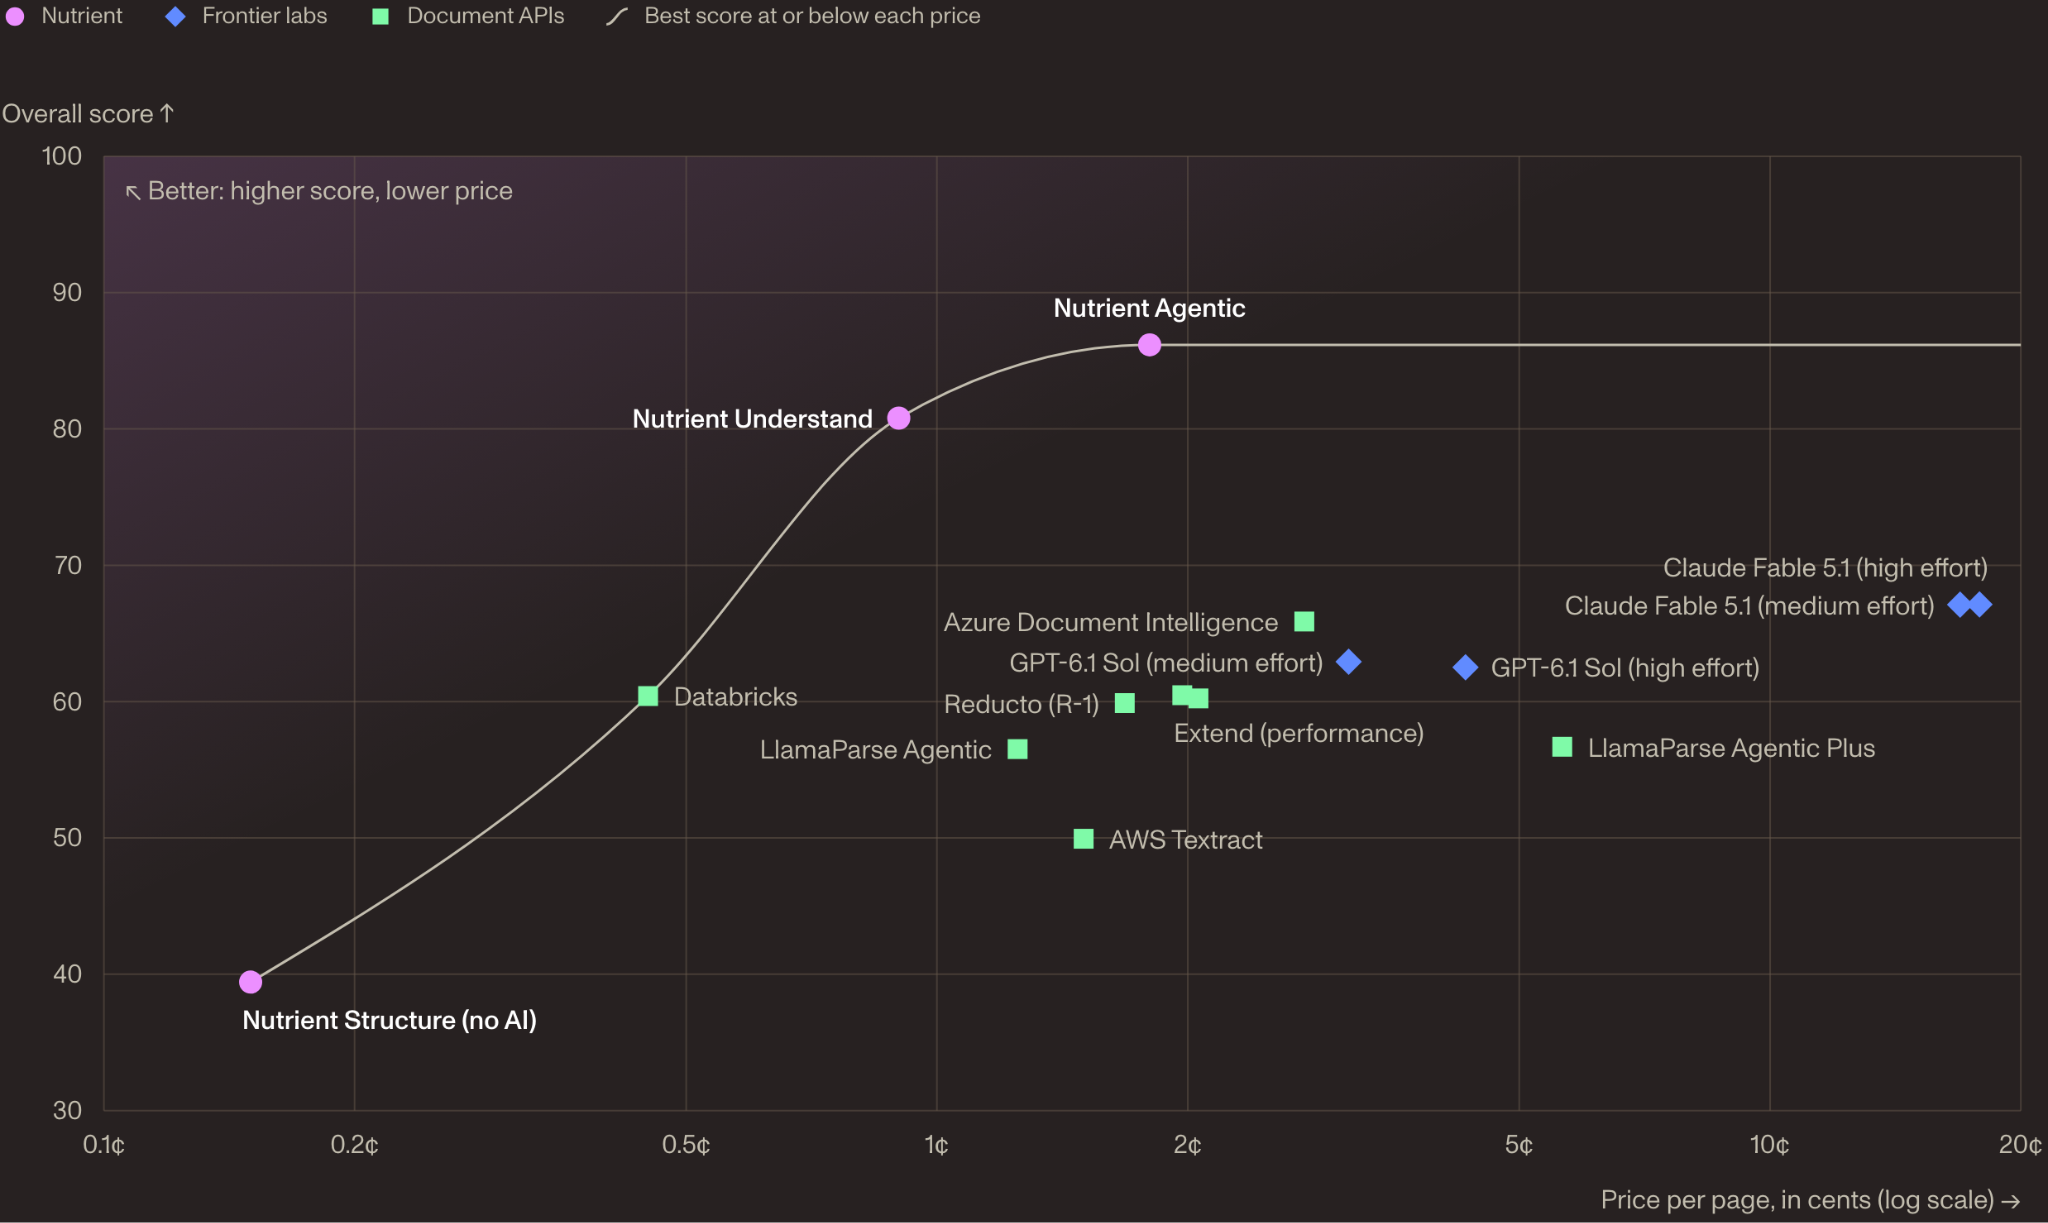
Nowy WholeDoc Bench firmy Nutrient ocenia całe dokumenty, a nie pojedyncze strony: 480 dokumentów, ponad 30 języków, 7 obszarów.
| Ustawienie | Ogólnie | Tabele | Wykresy | Pozycja | ¢/strona |
| Nutrient Agentic | 86,2 | 87,1 | 64,5 | 88,6 | 1,8 |
| Nutrient Understand | 80,8 | 86,1 | 35,1 | 86,4 | 0,9 |
| Claude Fable 5.1 (duże wysiłki) | 67,1 | 84,7 | 58,9 | 66,0 | 17,8 |
| Azure Document Intelligence | 65,9 | 69,4 | 0 | 72,5 | ≈2,8 |
| GPT-6.1 Sol (średni wysiłek) | 62,9 | 82,8 | 47,6 | 49,3 | ≈3,1 |
| Extend (wydajność) | 60,5 | 80,8 | 40,6 | 75,2 | 2,0 |
| Reducto (R-1) | 59,9 | 76,4 | 38,5 | 76,4 | ≈1,7 |
| LlamaParse Agentic Plus | 56,7 | 89,5 | 0* | 65,4 | ≈5,6 |
| AWS Textract | 49,9 | 71,4 | 0 | 70,0 | 1,5 |
| Docling | 40,0 | 63,9 | 20,2 | 0 | Local |
Wybrane wiersze, klasyfikacja WholeDoc, 5 listopada 2026 r., ceny listowe. *Wynik nadal jest poddawany ocenie.
Największą luką jest ciągłość między stronami. W przypadku 44 dokumentów z tabelami rozciągającymi się na kilka stron, 15 z 19 ustawień rzadko zachowywało je w całości.
Nutrient stworzył i przetestował to rozwiązanie, a główny zestaw testowy jest prywatny. Kod jest dostępny na licencji Apache-2.0, wraz z publicznym próbką składającą się z 10 dokumentów.
Główne wnioski
- Pola zawierają informacje o stronach, regionach, etykietach dopasowania oraz, jeśli dostępne, poziomie pewności.
- Konfiguruj i testuj w Studio przed pisaniem jakiegokolwiek kodu API.
- Ekstrakcja w trybie Understand kosztuje 15 USD za 1 000 stron.
- Agentic wyprzedza Nutrient’s WholeDoc Bench z wynikiem 86,2 przy koszcie 1,8 centa za stronę.
- Wykresy nadal są trudne do ekstrakcji: najlepszy wynik dla wykresów w WholeDoc to 64,5.
Zobacz API do ekstrakcji danych, benchmarki, serwer MCP oraz umiejętności agenta na GitHub.
Dziękujemy zespołowi AI Nutrient za liderstwo myślowe i udostępnione zasoby do tego artykułu. Ten artykuł jest sponsorowany.
Post Nutrient Data Extraction API: JSON Matching Your Schema With Per-Field Citations and Confidence ukazał się po raz pierwszy na blogu MarkTechPost.