
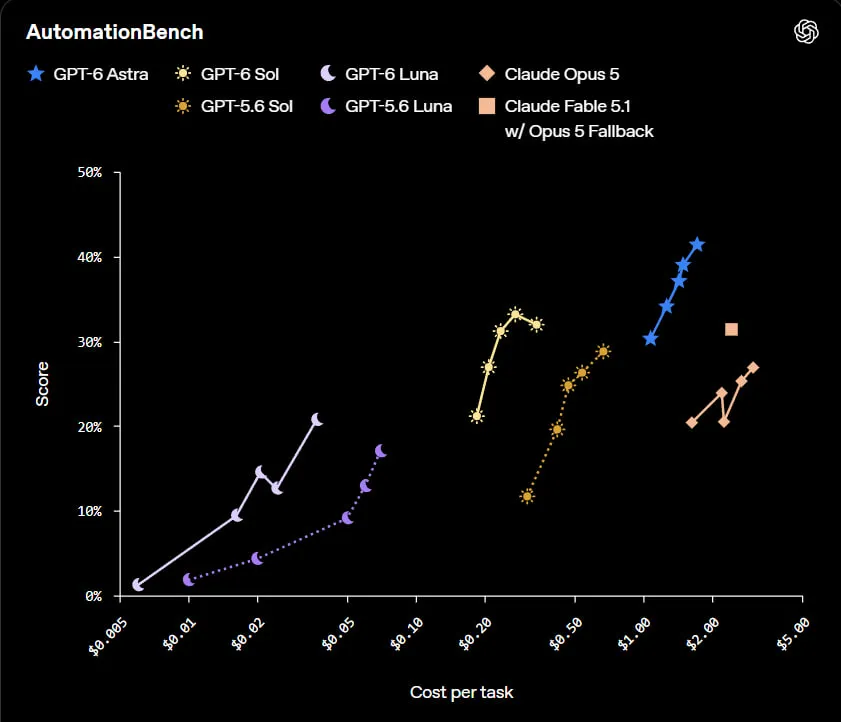
Dalam pengujian tugas kerja, AutomationBench Sol mengungguli Claude Opus 5 (33,2% berbanding 26,9%) dan Fable 5.1 (31,4%)—dan biaya penyelesaian tugasnya sekitar 11 kali lebih murah dibandingkan Opus 5.
Dalam pengujian internal kesalahan nyata, Sol mengalami penurunan hingga setengahnya dibandingkan GPT-5.6. Model ini mendekati tingkat keandalan Astra dengan harga yang lebih rendah. Tarif dasar API untuk Sol telah diturunkan sebesar 50% ($2/$10 per juta token), sedangkan untuk Luna turun sebesar 50-58%.
Sol—untuk pemrograman kompleks dan tugas agen (pengembangan fitur, review kode, debugging, analisis data); Luna—untuk tugas-tugas yang lebih sederhana dan massal seperti summarisasi dan ekstraksi data.
Lanjutkan membaca artikel ini di sumber: openai.com