
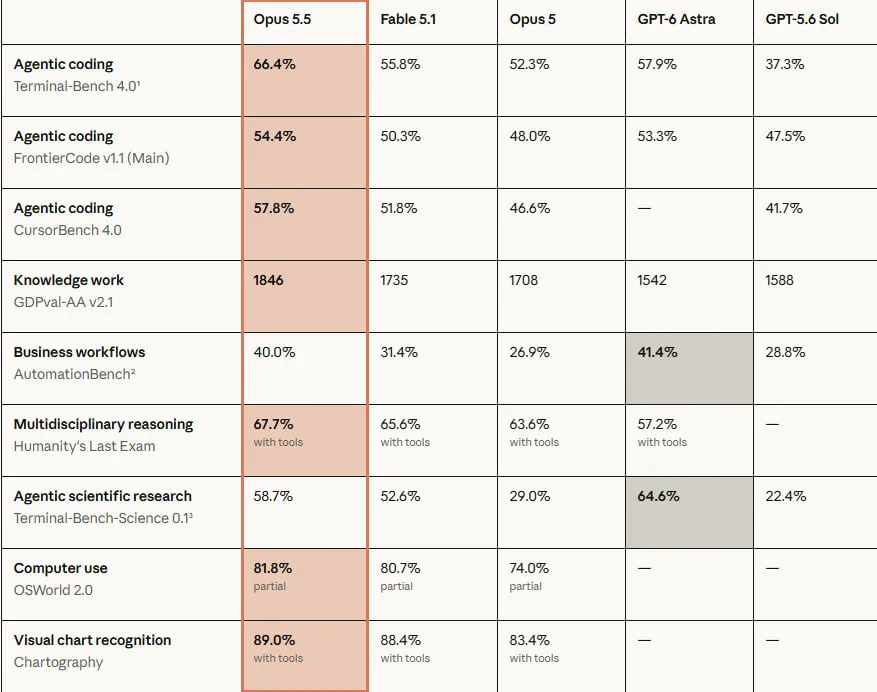
Dalam hal kinerja, model ini tidak kalah dari Claude Fable 5.1 dalam sebagian besar tugas dan biayanya 40% lebih murah untuk dioperasikan dibandingkan Opus 5.
Dalam uji coba benchmark, model ini mengungguli GPT-5.6 Sol dalam 6 dari 6 pengujian umum, serta GPT-6 Astra dalam 4 dari 6 (pengujian independen membenarkan setidaknya Terminal-Bench 4.0: 66,4% berbanding 57,9% untuk Astra)
Pengguna mencatat peningkatan kecepatan yang nyata dalam tugas-tugas nyata—misalnya, audit basis kode sebanyak 200 ribu baris hanya memerlukan waktu kurang dari 3 jam, berbanding lebih dari 20 jam pada versi sebelumnya.
Lanjutkan membaca artikel ini di sumber: anthropic.com