
Sebuah LLM menyajikan nilai yang salah yang diekstraksi dari dokumen sebagai fakta. Kesalahan tersebut berdampak mahal, terutama ketika pengambilan keputusan didasarkan padanya. Nutrient Data Extraction API dirancang untuk mengatasi masalah tersebut. API ini mengurai PDF, pemindaian, gambar, dan file Office menjadi JSON spasial atau Markdown. Ekstrak bidang-bidang dari dokumen ke dalam skema JSON Anda, serta fitur pemisahan, klasifikasi, dan pembentukan endpoint menyediakan primitif yang berguna untuk pipeline dokumen Anda. Setiap nilai yang diekstraksi dihubungkan dengan sebuah halaman melalui kotak batas, label kecocokan, dan skor kepercayaan. Nutrient (sebelumnya PSPDFKit) menjalankan mesin yang sama di balik MCP server, keterampilan agen, aplikasi Mac, dan SDK.
TL;DR
- Ukuran: API terhosting dengan 4 mode parsing plus perutean otomatis.
- Berjalan pada: Cloud Nutrient, server Anda sendiri melalui SDK, atau Mac berbasis Apple silicon.
- Tempat mencobanya: Studio, ruang kerja berbasis browser untuk mengonfigurasi dan menguji parsing, ekstraksi, klasifikasi, pemisahan, dan pengisian formulir.
- Kinerja: 86,2 secara keseluruhan pada WholeDoc Bench Nutrient, tertinggi di antara 19 pengaturan (API langsung, Agentic).
- Terbaik: 86,2 dengan biaya 1,8¢ per halaman, dibandingkan 67,1 dengan biaya 17,8¢ untuk pengaturan model frontier terbaik.
Bagaimana cara mengujinya di Studio sebelum menulis kode?
Studio adalah ruang kerja berbasis browser Nutrient untuk mengonfigurasi dan menguji API sebelum mengintegrasikannya ke dalam aplikasi Anda. Studio memungkinkan Anda menguji parsing, ekstraksi, klasifikasi, pemisahan, dan pengisian formulir pada file Anda sendiri. Siklus umumnya:
- Unggah dokumen sampel dan atur parameter yang akan Anda kirim.
- Buat draf skema di UI, atau hasilkan satu berdasarkan dokumen Anda sendiri.
- Jalankan pada dokumen baru, lalu periksa nilai dan sitasi.
- Simpan pengaturan sebagai preset ber versi. API menyebutnya sebagai prosesor, dengan ID proc.
- Nilai versi preset terhadap hingga 25 dokumen yang ditinjau dalam set evaluasi.
Prosesor yang disimpan di Studio kemudian dapat dipanggil dari API berdasarkan ID.
Mode mana yang harus Anda pilih?
Auto merutekan setiap halaman ke structure, understand, atau agentic. Jika mode tidak disebutkan, API secara default menggunakan understand.
| Operasi | Terbaik untuk | Harga per halaman | Ekstrak per halaman | WholeDoc Bench* |
| Parsing: teks | PDF dan file Office digital asli, tanpa OCR | $0,001 | $0,007** | Tidak diuji |
| Parsing: structure | OCR untuk pemindaian dengan tata letak sederhana, tanpa AI | $0,0015 | $0,0075 | 39,4 |
| Parsing: understand | Analisis tata letak berbasis AI: formulir, tata letak kompleks | $0,009 | $0,015 | 80,8 |
| Parsing: agentic | Model bahasa visi: tulisan kursif, pemindaian rusak, grafik | $0,018 | $0,024 | 86,2 |
| Klasifikasi | Label dokumen zero-shot | $0,001 | n/a | n/a |
| Pemisahan | Memisahkan PDF yang digabungkan menjadi beberapa dokumen | $0,003 | n/a | n/a |
*Skor parsing WholeDoc Bench, 5 November 2026; bukan akurasi ekstraksi. Ekstrak menambah $0,006 per halaman. **Dokumentasi API mencantumkan ekstrak mode teks; keterampilan agen dimulai dari structure.
Harga dalam dolar, mulai dari 1 saldo yang dibagikan melalui API cloud Nutrient, sehingga tim dapat menggabungkan berbagai opsi. Paket gratis memberikan penggunaan bulanan sebesar $5 yang mencakup sekitar 330 ekstraksi mode pemahaman. Starter berharga $75 per bulan untuk penggunaan $90; Growth berharga $275 untuk $345.
Bagaimana cara kerja kepercayaan yang membumi?
Dalam posisi kepercayaan Nutrient, sebuah bidang mendapat skor 0,97 tetapi berasal dari kolom yang salah.
Skor saat ini merupakan komposit dari sinyal opsional: probabilitas token, margin kandidat, landasan, dan format. Model landasan NLI Nutrient model landasan tersedia secara terbuka di bawah Apache-2.0. Nilai yang membumi masih dapat menjawab bidang yang salah. Ketika tidak ada skor, kepercayaan dihilangkan, bukan rendah.
Setiap bidang juga mendapatkan label kecocokan: id_match, id_match_multiblock, id_match_partial, fuzzy_match, atau not_found. Filter berdasarkan label terlebih dahulu, baru kemudian kepercayaan.
Salin KodeDisalinGunakan Browser Lain
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "Nomor faktur di bawah detail pemasok."},
        "total_amount": {"type": "number", "description": "Total akhir yang dicetak termasuk pajak. Bukan subtotal."},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # hanya sebagai ilustrasi; evaluasi pada dokumen representatif

for field in schema["properties"]:  # loop over expected fields so none skip review
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = no score
    passes = (value is not None and match in EXACT
              and conf is not None and conf >= THRESHOLD)
    print(field, value, match, conf, "halaman", meta.get("pageNumber"),
          "LULUS_PENGECEKAN_DASAR" jika lulus, "TINJAUAN" jika tidak)
Demo ini hanya mencakup skema datar; produksi memerlukan pemeriksaan tipe dan aturan bisnis. Batas 0,97 mencerminkan bidang uang dalam tutorial hipotek Nutrient.
Bagaimana cara kerja classify dan split?
Model keputusan dokumen mendukung classify dan split. Nutrient melaporkan F1 split 96,2% dibandingkan 63,7% untuk Jev dari Typesafe AI.
Bagaimana agen menggunakannya?
Server MCP yang dihosting tidak memerlukan kunci API. Claude Code terhubung dengan 1 perintah:
Salin KodeDisalinGunakan Browser Lain
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude dan Codex juga bekerja melalui OAuth. Mode agen default berbiaya $0,018 per halaman untuk parsing.
Agen pemrograman dapat menginstal keterampilan document-extraction-api dengan npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api.
Apakah bisa dijalankan secara lokal?
Pada aplikasi Mac, dokumen tetap bersifat lokal hanya dengan model lokal. Produksi sepenuhnya offline memerlukan SDK.
Bagaimana skornya di WholeDoc Bench?
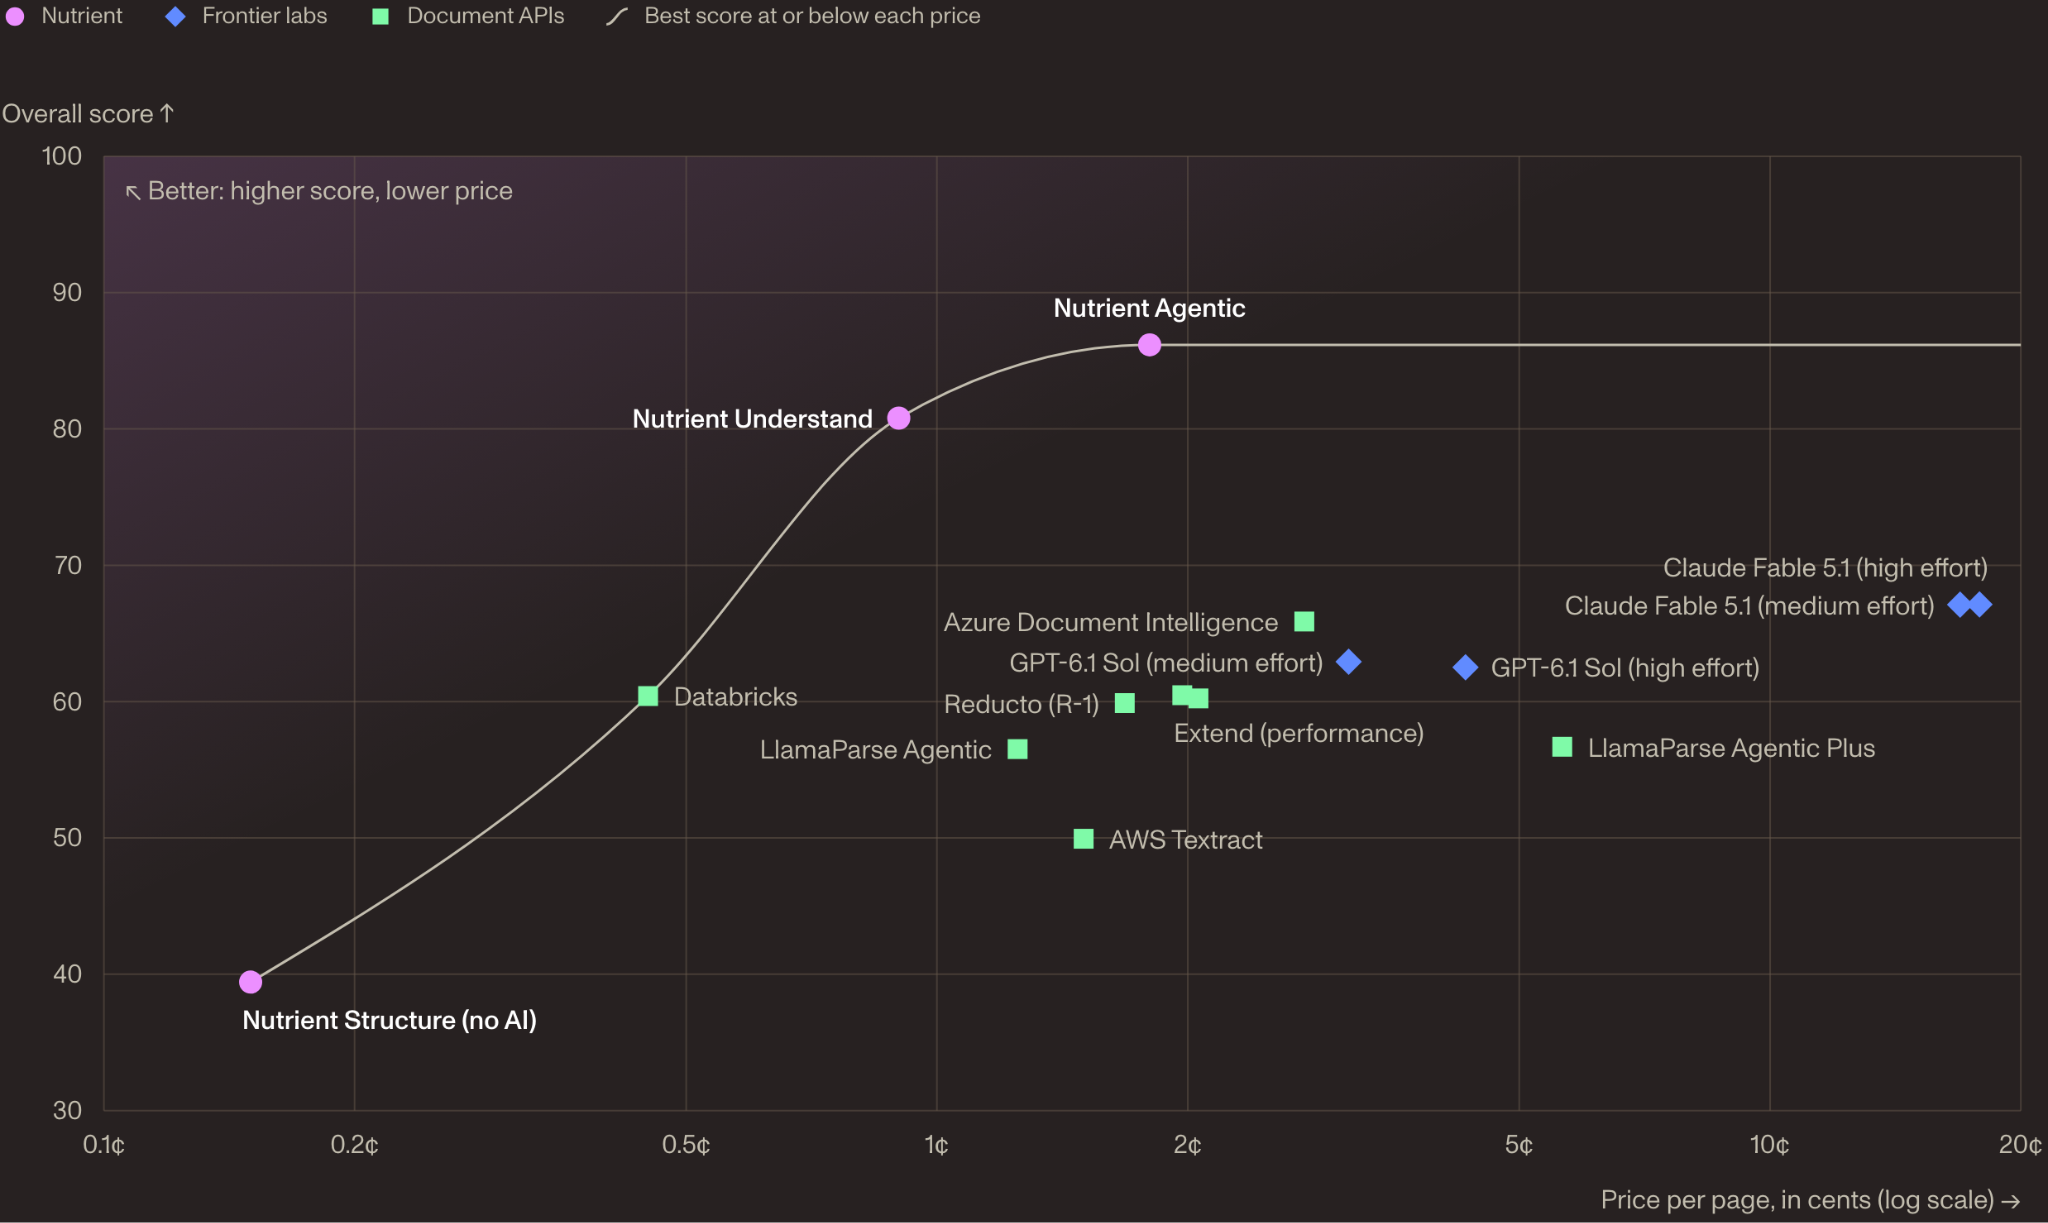
Skor baru WholeDoc Bench dari Nutrient menilai dokumen secara keseluruhan, bukan halaman tunggal: 480 dokumen, lebih dari 30 bahasa, 7 area.
| Setting | Overall | Tables | Charts | Position | ¢/page |
| Nutrient Agentic | 86.2 | 87.1 | 64.5 | 88.6 | 1.8 |
| Nutrient Understand | 80.8 | 86.1 | 35.1 | 86.4 | 0.9 |
| Claude Fable 5.1 (high effort) | 67.1 | 84.7 | 58.9 | 66.0 | 17.8 |
| Azure Document Intelligence | 65.9 | 69.4 | 0 | 72.5 | ≈2.8 |
| GPT-6.1 Sol (medium effort) | 62.9 | 82.8 | 47.6 | 49.3 | ≈3.1 |
| Extend (performance) | 60.5 | 80.8 | 40.6 | 75.2 | 2.0 |
| Reducto (R-1) | 59.9 | 76.4 | 38.5 | 76.4 | ≈1.7 |
| LlamaParse Agentic Plus | 56.7 | 89.5 | 0* | 65.4 | ≈5.6 |
| AWS Textract | 49.9 | 71.4 | 0 | 70.0 | 1.5 |
| Docling | 40.0 | 63.9 | 20.2 | 0 | Local |
Baris terpilih, WholeDoc leaderboard, 5 November 2026, harga daftar. *Skor masih dalam peninjauan.
Kesinambungan lintas halaman merupakan celah terbesar. Pada 44 dokumen dengan tabel yang meliputi beberapa halaman, 15 dari 19 setting jarang dapat mempertahankannya secara utuh.
Nutrient yang membangun dan menjalankannya, dan set tes utama bersifat privat. Code berlisensi Apache-2.0, dengan sampel publik berisi 10 dokumen.
Poin Penting
- Field mencakup halaman, region, label kecocokan, dan jika tersedia, tingkat kepercayaan.
- Konfigurasikan dan uji di Studio sebelum menulis kode API apa pun.
- Ekstraksi mode Understand dikenakan biaya $15 per 1.000 halaman.
- Agentic mendominasi WholeDoc Bench Nutrient dengan skor 86.2 untuk biaya 1,8¢ per halaman.
- Chart tetap sulit: 64.5 adalah skor chart WholeDoc terbaik.
Lihat Data Extraction API, benchmarks, MCP server, dan agent skill on GitHub.
Terima kasih kepada tim AI Nutrient atas kepemimpinan pemikiran / sumber daya untuk artikel ini. Artikel ini disponsori.
Postingan Nutrient Data Extraction API: JSON Matching Your Schema With Per-Field Citations and Confidence pertama kali muncul di MarkTechPost.