
एक LLM आपको किसी दस्तावेज़ से निकाला गया गलत मूल्य को तथ्य के रूप में प्रस्तुत करता है। यह त्रुटि महंगी पड़ती है, खासकर जब इस पर आधारित निर्णय लिए जाते हैं। Nutrient Data Extraction API इस समस्या को निशाना बनाता है। यह PDF, स्कैन, छवियों और Office फ़ाइलों को स्थानिक JSON या Markdown में पार्स करता है। दस्तावेज़ से फ़ील्ड को अपने JSON स्कीमा पर निकालें, और स्प्लिटिंग, क्लासिफ़िकेशन तथा फ़ॉर्म एंडपॉइंट्स आपके दस्तावेज़ पाइपलाइन्स के लिए उपयोगी प्राथमिकताएँ प्रदान करते हैं। प्रत्येक निकाला गया मूल्य एक बाउंडिंग बॉक्स, एक मैच लेबल और एक कॉन्फ़िडेंस स्कोर के माध्यम से एक पृष्ठ से जुड़ा होता है। Nutrient (पूर्व में PSPDFKit) एक MCP सर्वर, एजेंट स्किल, Mac ऐप और SDK के पीछे वही इंजन चलाता है।
TL;DR
- आकार: 4 पार्स मोड के साथ एक होस्टेड API, साथ ही ऑटो रूटिंग।
- चलाता है: Nutrient क्लाउड, SDK के माध्यम से आपके अपने सर्वर या Apple सिलिकॉन Mac।
- इसे आज़माने के लिए: Studio, एक ब्राउज़र वर्कस्पेस जहाँ आप पार्सिंग, निकालना, क्लासिफ़िकेशन, स्प्लिटिंग और फ़ॉर्म भरने को कॉन्फ़िगर और परीक्षण कर सकते हैं।
- प्रदर्शन: Nutrient’s WholeDoc Bench पर 86.2 कुल स्कोर, 19 सेटिंग्स (लाइव API, Agentic) में शीर्ष।
- सर्वश्रेष्ठ: $0.018 प्रति पृष्ठ पर 86.2, जबकि सर्वश्रेष्ठ फ्रंटियर-मॉडल सेटिंग के लिए $0.018 प्रति पृष्ठ पर 67.1 है।
आप कोड लिखने से पहले Studio में इसे कैसे परीक्षण करते हैं?
Studio Nutrient का ब्राउज़र वर्कस्पेस है जहाँ आप अपने एप्लिकेशन में इसे एकीकृत करने से पहले API को कॉन्फ़िगर और परीक्षण कर सकते हैं। यह आपको पार्सिंग, निकालना, क्लासिफ़िकेशन, स्प्लिटिंग और फ़ॉर्म भरने का परीक्षण करने की अनुमति देता है, अपनी खुद की फ़ाइलों पर। एक विशिष्ट लूप:
- एक नमूना दस्तावेज़ अपलोड करें और वे पैरामीटर सेट करें जो आप भेजने की योजना बना रहे हैं।
- UI में एक स्कीमा ड्राफ़्ट करें, या अपने खुद के दस्तावेज़ों के आधार पर एक जनरेट करें।
- इसे एक नए दस्तावेज़ पर चलाएँ, फिर मूल्यों और उद्धरणों का निरीक्षण करें।
- सेटअप को एक संस्करणबद्ध प्रीसेट के रूप में सहेजें। API इसे प्रोसेसर कहता है, जिसके पास एक proc_ ID होता है।
- एक मूल्यांकन सेट में 25 तक समीक्षित दस्तावेज़ों के साथ प्रीसेट संस्करणों को स्कोर करें।
Studio में सहेजे गए प्रोसेसरों को बाद में API से ID द्वारा कॉल किया जा सकता है।
आपको कौन सा मोड चुनना चाहिए?
ऑटो प्रत्येक पृष्ठ को स्ट्रक्चर, अंडरस्टैंड या एजेंटिक में रूट करता है। यदि मोड छोड़ दिया जाता है, तो API डिफ़ॉल्ट रूप से अंडरस्टैंड करता है।
| ऑपरेशन | सर्वश्रेष्ठ के लिए | प्रति पृष्ठ मूल्य | प्रति पृष्ठ निकालना | WholeDoc Bench* |
| पार्स: टेक्स्ट | बोर्न-डिजिटल PDF और Office फ़ाइलें, कोई OCR नहीं | $0.001 | $0.007** | परीक्षण नहीं किया गया |
| पार्स: स्ट्रक्चर | सरल लेआउट वाले स्कैन के लिए OCR, कोई AI नहीं | $0.0015 | $0.0075 | 39.4 |
| पार्स: अंडरस्टैंड | AI लेआउट विश्लेषण: फ़ॉर्म, जटिल लेआउट | $0.009 | $0.015 | 80.8 |
| पार्स: एजेंटिक | विज़न लैंग्वेज मॉडल: कर्सिव, खराब स्कैन, चार्ट | $0.018 | $0.024 | 86.2 |
| क्लासिफ़िकेशन | ज़ीरो-शॉट दस्तावेज़ लेबल | $0.001 | n/a | n/a |
| स्प्लिटिंग | मर्ज़ किए गए PDF को दस्तावेज़ों में अलग करना | $0.003 | n/a | n/a |
*WholeDoc Bench पार्सिंग स्कोर, 5 नवंबर 2026; निकालने की सटीकता नहीं। निकालने पर प्रति पृष्ठ $0.006 जोड़ा जाता है। **API डॉक्स में टेक्स्ट-मोड निकालना बताया गया है; एजेंट स्किल स्ट्रक्चर से शुरू होता है।
मूल्य निर्धारण डॉलर में है, जो Nutrient के क्लाउड API पर साझा किए गए 1 बैलेंस से है, इसलिए टीमें मिश्रण और मिलान कर सकती हैं। नि:शुल्क योजना आपको प्रति माह $5 का उपयोग देती है जो लगभग 330 अंडरस्टैंड-मोड निष्कर्षण को कवर करता है। स्टार्टर की कीमत $75 प्रति माह है जिसमें $90 का उपयोग शामिल है; ग्रोथ की कीमत $275 है जिसमें $345 का उपयोग शामिल है।
ग्राउंडेड कॉन्फिडेंस कैसे काम करता है?
Nutrient के कॉन्फिडेंस पोस्ट में, एक फ़ील्ड को 0.97 स्कोर दिया गया था लेकिन यह गलत कॉलम से आया था।
वर्तमान स्कोर वैकल्पिक सिग्नलों का कंपोजिट है: टोकन संभावना, कैंडिडेट मार्जिन, ग्राउंडिंग और फॉर्मेट। Nutrient का NLI ग्राउंडिंग मॉडल Apache-2.0 के तहत खुला है। एक ग्राउंडेड मूल्य अभी भी गलत फ़ील्ड का उत्तर दे सकता है। जब कोई स्कोर मौजूद नहीं होता है, तो कॉन्फिडेंस छोड़ दिया जाता है, इसे कम नहीं माना जाता।
प्रत्येक फ़ील्ड को एक मैच लेबल भी मिलता है: id_match, id_match_multiblock, id_match_partial, fuzzy_match या not_found। पहले लेबल पर गेट करें, फिर कॉन्फिडेंस।
कोड कॉपी करेंकॉपी किया गया एक अलग ब्राउज़र का उपयोग करें
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "आपूर्तिकर्ता विवरण के नीचे चला गया इनवॉइस नंबर।"},
        "total_amount": {"type": "number", "description": "टैक्स सहित छपा अंतिम कुल। सबटोटल नहीं।"},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # केवल दिखाने के लिए; प्रतिनिधि दस्तावेजों पर मूल्यांकन करें

for field in schema["properties"]:  # अपेक्षित फ़ील्डों पर लूप ताकि कोई भी समीक्षा से छूट न जाए
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = कोई स्कोर नहीं
    पास होने के लिए शर्तें हैं: (value is not None and match in EXACT
              and conf is not None and conf >= THRESHOLD)
    print(field, value, match, conf, "page", meta.get("pageNumber"),
          "PASSES_BASIC_CHECKS" if passes else "REVIEW")
यह डेमो केवल फ्लैट स्कीमा को कवर करता है; उत्पादन के लिए प्रकार और व्यावसायिक नियम जाँचों की आवश्यकता होती है। 0.97 का बार Nutrient के मॉर्टगेज ट्यूटोरियल में पैसे के फ़ील्डों की नकल करता है।
क्लासिफ़ाय और स्प्लिट कैसे काम करते हैं?
एक दस्तावेज़ निर्णय मॉडल क्लासिफ़ाय और स्प्लिट को संचालित करता है। Nutrient 63.7% के लिए Typesafe AI के Jev के मुकाबले 96.2% स्प्लिट F1 रिपोर्ट करता है।
एजेंट इसे कैसे उपयोग करते हैं?
होस्टेड MCP सर्वर को किसी API कुंजी की आवश्यकता नहीं होती। Claude Code 1 कमांड के साथ कनेक्ट होता है:
कोड कॉपी करेंकॉपी किया गया एक अलग ब्राउज़र का उपयोग करें
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude और Codex OAuth के माध्यम से भी काम करते हैं। डिफ़ॉल्ट एजेंटिक मोड का प्रति पृष्ठ पार्सिंग खर्च $0.018 है।
कोडिंग एजेंट दस्तावेज़ निष्कर्षण-API कौशल को npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api के साथ इंस्टॉल कर सकते हैं।
क्या यह स्थानीय रूप से चलाया जा सकता है?
Mac ऐप पर, दस्तावेज़ केवल स्थानीय मॉडल के साथ स्थानीय रूप से रहते हैं। पूरी तरह से ऑफ़लाइन उत्पादन के लिए SDK की आवश्यकता होती है।
WholeDoc Bench पर यह कैसे स्कोर करता है?
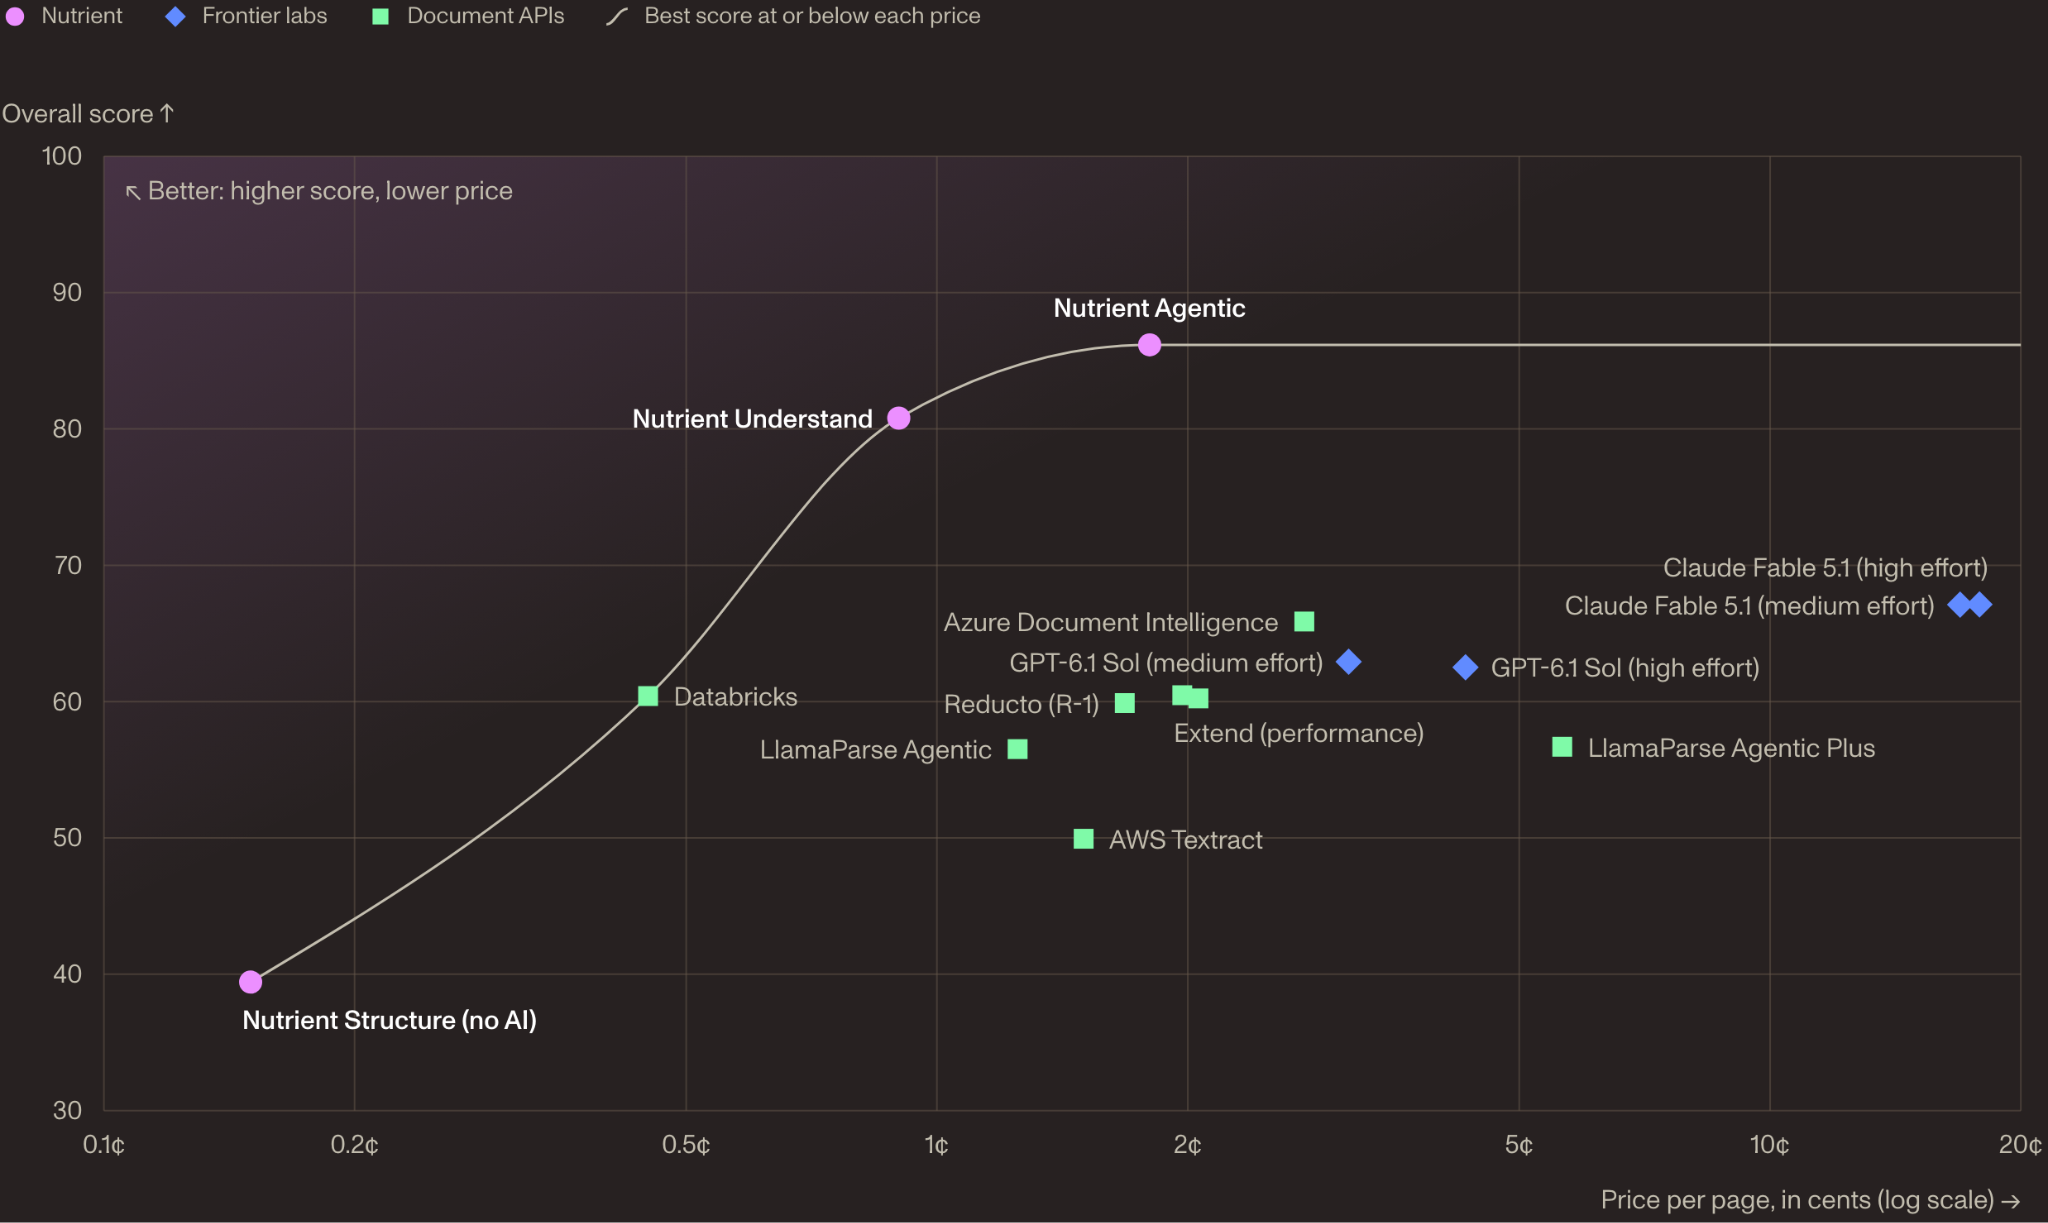
Nutrient का नया WholeDoc Bench पूरे दस्तावेजों का स्कोर करता है, न कि एकल पृष्ठों का: 480 दस्तावेज़, 30+ भाषाएँ, 7 क्षेत्र।
| सेटिंग | ओवरऑल | टेबल | चार्ट | पोज़िशन | ¢/पृष्ठ |
| Nutrient Agentic | 86.2 | 87.1 | 64.5 | 88.6 | 1.8 |
| Nutrient Understand | 80.8 | 86.1 | 35.1 | 86.4 | 0.9 |
| Claude Fable 5.1 (उच्च प्रयास) | 67.1 | 84.7 | 58.9 | 66.0 | 17.8 |
| Azure Document Intelligence | 65.9 | 69.4 | 0 | 72.5 | ≈2.8 |
| GPT-6.1 Sol (मध्यम प्रयास) | 62.9 | 82.8 | 47.6 | 49.3 | ≈3.1 |
| Extend (प्रदर्शन) | 60.5 | 80.8 | 40.6 | 75.2 | 2.0 |
| Reducto (R-1) | 59.9 | 76.4 | 38.5 | 76.4 | ≈1.7 |
| LlamaParse Agentic Plus | 56.7 | 89.5 | 0* | 65.4 | ≈5.6 |
| AWS Textract | 49.9 | 71.4 | 0 | 70.0 | 1.5 |
| Docling | 40.0 | 63.9 | 20.2 | 0 | स्थानीय |
चुनिंदा पंक्तियाँ, WholeDoc लीडरबोर्ड, 5 नवंबर 2026, सूची मूल्य। *स्कोर अभी भी समीक्षाधीन है।
पृष्ठों के बीच निरंतरता सबसे बड़ा अंतर है। 44 ऐसे दस्तावेज़ों पर जिनमें पृष्ठों में फैले टेबल हैं, 19 में से 15 सेटिंग्स उन्हें शायद ही पूरा रख पाईं।
Nutrient ने इसे बनाया और चलाया, और मुख्य परीक्षण सेट निजी है। कोड Apache-2.0 है, जिसमें 10 दस्तावेज़ों का सार्वजनिक नमूना शामिल है।
मुख्य निष्कर्ष
- फ़ील्ड पृष्ठों, क्षेत्रों, मैच लेबल और, जब उपलब्ध हो, विश्वसनीयता को भी ले जाते हैं।
- किसी भी API कोड लिखने से पहले Studio में कॉन्फ़िगर करें और परीक्षण करें।
- Understand-मोड निष्कर्षण की लागत 15 डॉलर प्रति 1,000 पृष्ठ है।
- Agentic Nutrient के WholeDoc Bench में 86.2 के साथ 1.8¢ प्रति पृष्ठ पर सबसे ऊपर है।
- चार्ट अभी भी कठिन हैं: 64.5 WholeDoc का सर्वश्रेष्ठ चार्ट स्कोर है।
Data Extraction API, benchmarks, MCP server और agent skill on GitHub देखें।
इस लेख के लिए विचार नेतृत्व / संसाधनों के लिए Nutrient AI टीम का धन्यवाद। यह लेख प्रायोजित है।
पोस्ट Nutrient Data Extraction API: JSON Matching Your Schema With Per-Field Citations and Confidence पहली बार MarkTechPost पर प्रकाशित हुई थी।