
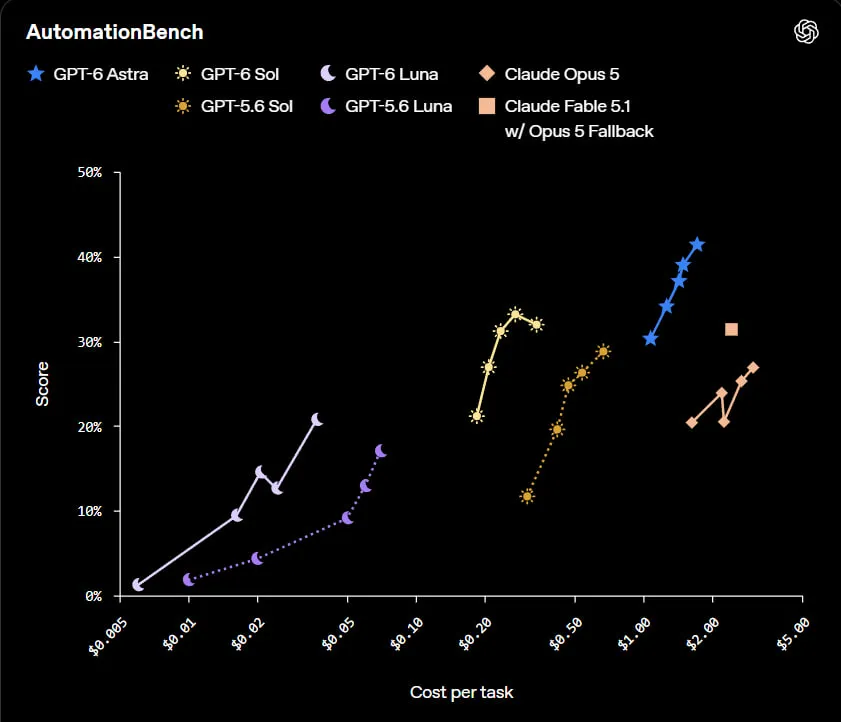
Dans le test des tâches de travail, AutomationBench Sol dépasse Claude Opus 5 (33,2 % contre 26,9 %) et Fable 5.1 (31,4 %) – tout en étant environ 11 fois moins coûteux à exécuter que Opus 5.
Dans le test interne des erreurs réelles, Sol présente deux fois moins d'erreurs par rapport à GPT-5.6. La modèle se rapproche ainsi de la fiabilité d'Astra tout en restant plus abordable. Les tarifs de base de l'API pour Sol ont été réduits de 50 % (2 $/10 $ par million de tokens), et ceux pour Luna de 50 à 58 %.
Sol est destiné aux tâches complexes de codage et aux missions d'agents (développement de fonctionnalités, revue de code, débogage, analyse de données), tandis que Luna convient mieux aux tâches plus simples et massives telles que la sommation et l'extraction de données.