
Un LLM vous présente une valeur erronée extraite d’un document comme un fait avéré. Cette erreur est coûteuse, surtout lorsqu’on fonde des décisions dessus. L'API d’extraction de données nutritionnelles vise à résoudre ce problème. Elle analyse les PDF, les scans, les images et les fichiers Office pour les convertir en JSON spatial ou en Markdown. Elle extrait les champs d’un document selon votre schéma JSON, et ses fonctions de fractionnement, de classification et de génération de formulaires fournissent des primitives utiles pour vos pipelines documentaires. Chaque valeur extraite est associée à une page via une boîte englobante, une étiquette de correspondance et un score de confiance. Nutrient (anciennement PSPDFKit) utilise le même moteur au cœur d’un serveur MCP, d’une compétence d’agent, d’une application Mac et d’un SDK.
En résumé
- Taille : Une API hébergée avec 4 modes d’analyse plus l’acheminement automatique.
- Exécution : Sur le cloud Nutrient, sur vos propres serveurs via SDK, ou sur un Mac à puce Apple.
- Où l’essayer : Studio, un espace de travail navigateur pour configurer et tester l’analyse, l’extraction, la classification, le fractionnement et le remplissage de formulaires.
- Performance : 86,2 au total sur le WholeDoc Bench de Nutrient, meilleur résultat parmi 19 configurations (API en direct, Agentic).
- Meilleur : 86,2 à 1,8 ¢ par page, contre 67,1 à 17,8 ¢ pour la meilleure configuration du modèle de pointe.
Comment le tester dans Studio avant d’écrire du code ?
Studio est l’espace de travail navigateur de Nutrient permettant de configurer et de tester l’API avant de l’intégrer à votre application. Il vous permet de tester l’analyse, l’extraction, la classification, le fractionnement et le remplissage de formulaires sur vos propres fichiers. Voici une séquence typique :
- Téléversez un document d’exemple et définissez les paramètres que vous prévoyez d’envoyer.
- Élaborez un schéma dans l’interface utilisateur, ou générez-en un à partir de vos propres documents.
- Exécutez le processus sur un nouveau document, puis examinez les valeurs et les citations.
- Enregistrez la configuration sous forme de préréglage versionné. L’API l’appelle processeur, avec un ID de proc.
- Évaluez les versions du préréglage sur jusqu’à 25 documents examinés dans un ensemble d’évaluation.
Les processeurs enregistrés dans Studio peuvent ensuite être invoqués depuis l’API par leur ID.
Quel mode choisir ?
Auto achemine chaque page vers structure, understand ou agentic. Si le mode est omis, l’API utilise understand par défaut.
| Opération | Idéal pour | Prix par page | Extraction par page | WholeDoc Bench* |
| Analyse : texte | PDF et fichiers Office natifs numériques, sans OCR | 0,001 $ | 0,007 $** | Non testé |
| Analyse : structure | OCR pour scans aux mises en page simples, sans IA | 0,0015 $ | 0,0075 $ | 39,4 |
| Analyse : understand | IA pour l’analyse de mise en page : formulaires, mises en page complexes | 0,009 $ | 0,015 $ | 80,8 |
| Analyse : agentic | Modèle de vision-langage : écriture cursive, scans dégradés, graphiques | 0,018 $ | 0,024 $ | 86,2 |
| Classification | Étiquettes de documents zéro-shot | 0,001 $ | n/a | n/a |
| Fractionnement | Séparer des PDF fusionnés en plusieurs documents | 0,003 $ | n/a | n/a |
*Score d’analyse du WholeDoc Bench, 5 novembre 2026 ; il ne s’agit pas de précision d’extraction. L’extraction ajoute 0,006 $ par page. **La documentation de l’API mentionne l’extraction en mode texte ; la compétence d’agent commence en mode structure.
Les tarifs sont indiqués en dollars, à partir d'un solde partagé via les API cloud de Nutrient, ce qui permet aux équipes de combiner différents services. Le plan gratuit offre 5 $ d'utilisation mensuelle, couvrant environ 330 extractions en mode compréhension. Starter coûte 75 $ par mois pour 90 $ d'utilisation ; Growth coûte 275 $ pour 345 $.
Comment fonctionne la confiance fondée ?
Dans le post sur la confiance de Nutrient, un champ noté 0,97 provenait cependant de la mauvaise colonne.
Le score actuel est un composite de signaux optionnels : probabilité du jeton, marge du candidat, fondement et format. Le modèle de fondement NLI de Nutrient est open source sous Apache-2.0. Une valeur fondée peut toutefois répondre au mauvais champ. Lorsqu'aucun score n'existe, la confiance est omise, et non considérée comme faible.
Chaque champ reçoit également une étiquette de correspondance : id_match, id_match_multiblock, id_match_partial, fuzzy_match ou not_found. Priorisez l'étiquette avant d'évaluer la confiance.
Copier le codeCopiéUtiliser un autre navigateur
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "Numéro de facture situé sous les coordonnées du fournisseur."},
        "total_amount": {"type": "number", "description": "Montant total imprimé, taxes incluses. Pas le sous-total."},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # uniquement à titre illustratif ; à évaluer sur des documents représentatifs

for field in schema["properties"]:  # itérer sur les champs attendus afin qu'aucun ne soit sauté lors de la révision
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = pas de score
    passes = (value is not None et match dans EXACT
              et conf is not None et conf >= THRESHOLD)
    print(field, value, match, conf, "page", meta.get("pageNumber"),
          "PASSES_BASIC_CHECKS" si passes else "REVIEW")
Cette démo ne prend en charge que les schémas plats ; la production nécessite des vérifications de type et de règles métier. Le seuil de 0,97 reflète les champs monétaires dans le tutoriel hypothécaire de Nutrient.
Comment fonctionnent classify et split ?
Un modèle de décision documentaire alimente classify et split. Nutrient rapporte un F1 de split de 96,2 % contre 63,7 % pour Jev de Typesafe AI.
Comment les agents l'utilisent-ils ?
Le serveur MCP hébergé ne nécessite aucune clé API. Claude Code se connecte avec une seule commande :
Copier le codeCopiéUtiliser un autre navigateur
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude et Codex fonctionnent également via OAuth. Le mode agencique par défaut coûte 0,018 $ par page analysée.
Les agents développeurs peuvent installer la compétence document-extraction-api avec npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api.
Peut-il être exécuté localement ?
Sur l'application Mac, les documents restent locaux uniquement avec un modèle local. La production entièrement hors ligne nécessite le SDK.
Quelle est sa performance sur WholeDoc Bench ?
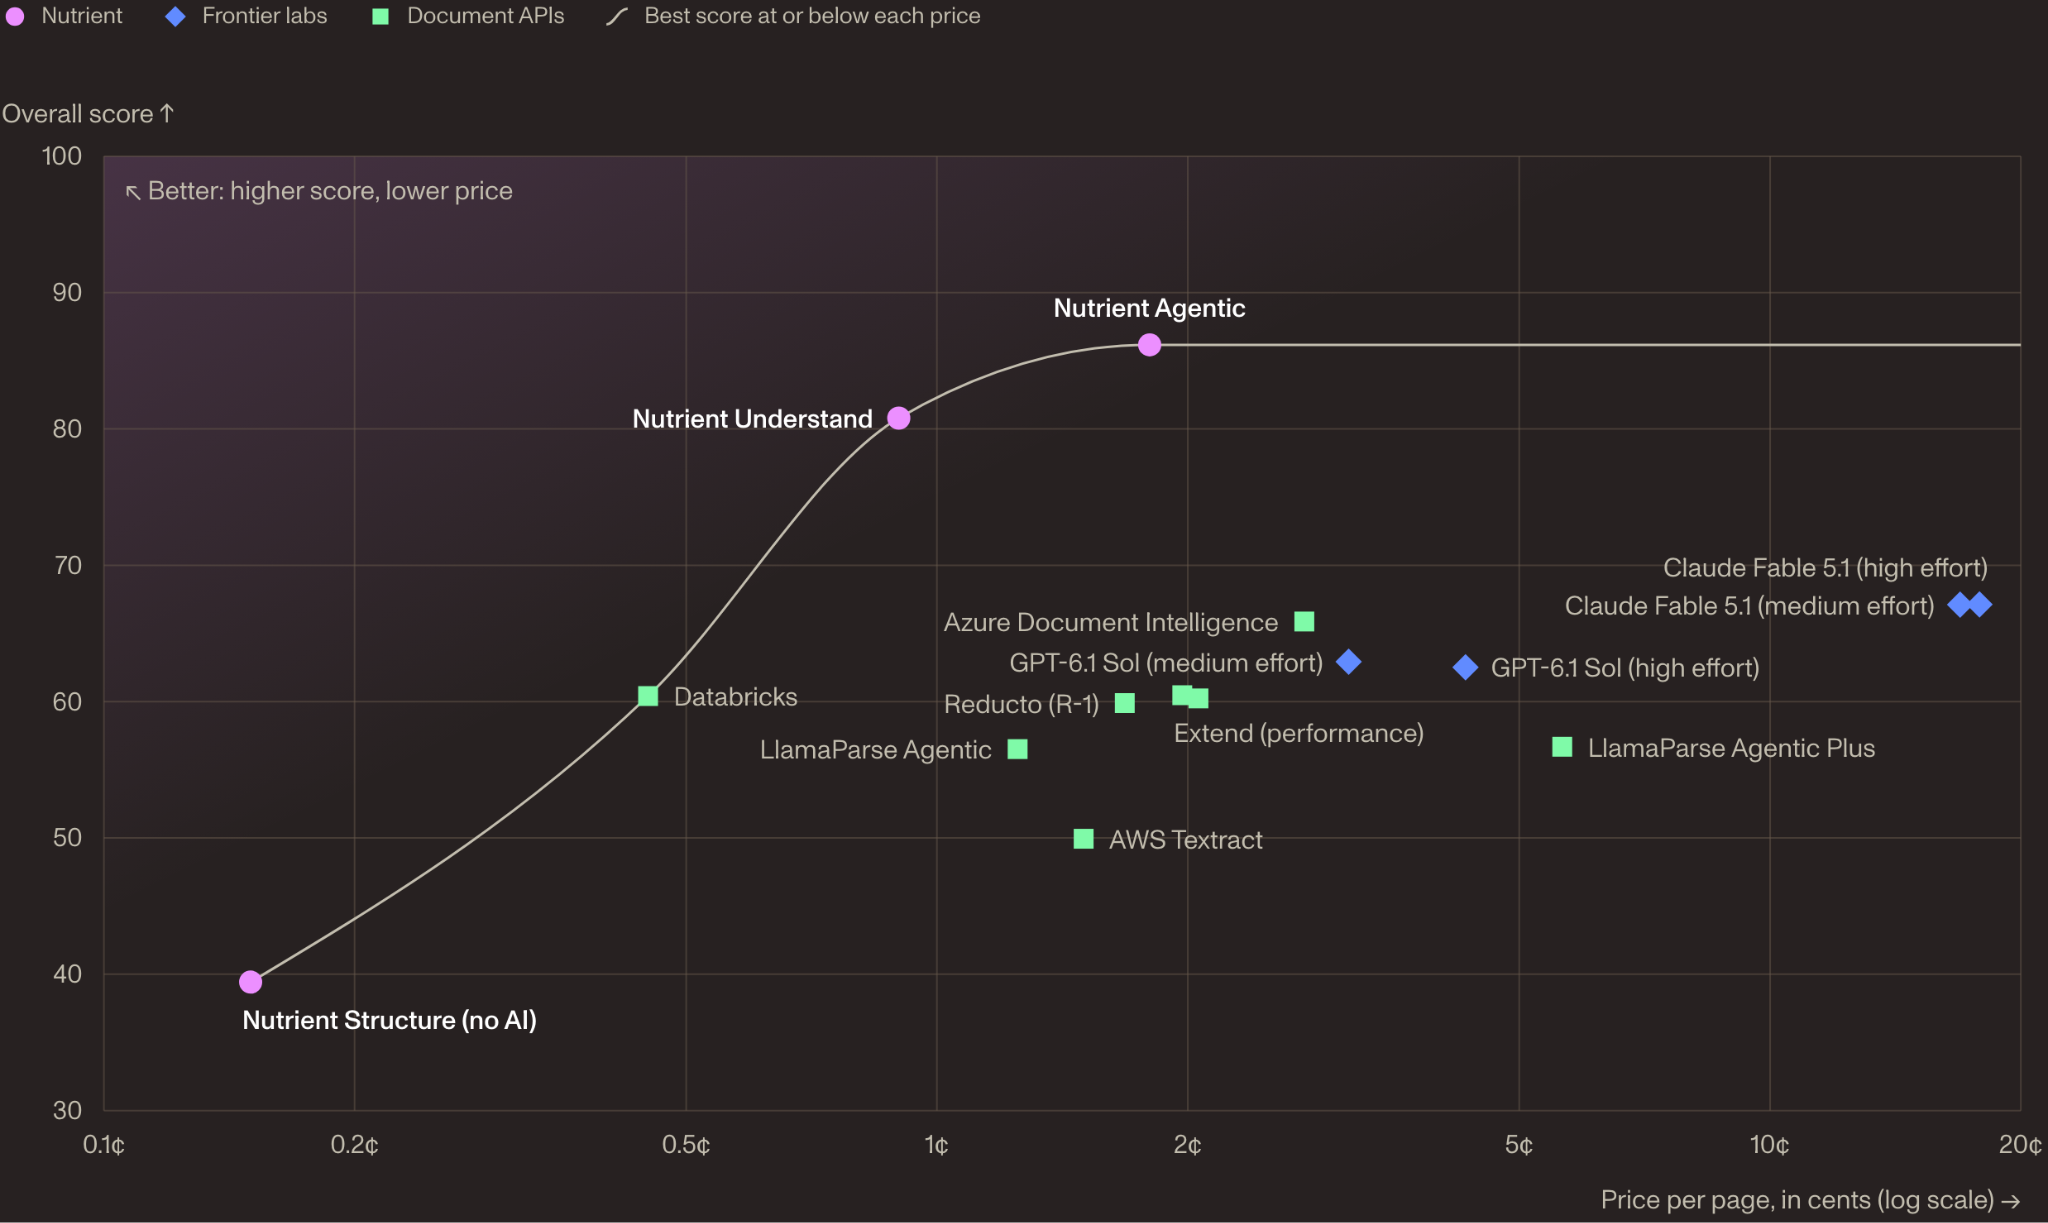
Le nouveau WholeDoc Bench de Nutrient évalue des documents entiers, et non des pages individuelles : 480 documents, plus de 30 langues, 7 domaines.
| Paramètre | Général | Tableaux | Graphiques | Position | ¢/page |
| Nutrient Agentic | 86,2 | 87,1 | 64,5 | 88,6 | 1,8 |
| Nutrient Understand | 80,8 | 86,1 | 35,1 | 86,4 | 0,9 |
| Claude Fable 5.1 (effort élevé) | 67,1 | 84,7 | 58,9 | 66,0 | 17,8 |
| Azure Document Intelligence | 65,9 | 69,4 | 0 | 72,5 | ≈2,8 |
| GPT-6.1 Sol (effort moyen) | 62,9 | 82,8 | 47,6 | 49,3 | ≈3,1 |
| Extend (performance) | 60,5 | 80,8 | 40,6 | 75,2 | 2,0 |
| Reducto (R-1) | 59,9 | 76,4 | 38,5 | 76,4 | ≈1,7 |
| LlamaParse Agentic Plus | 56,7 | 89,5 | 0* | 65,4 | ≈5,6 |
| AWS Textract | 49,9 | 71,4 | 0 | 70,0 | 1,5 |
| Docling | 40,0 | 63,9 | 20,2 | 0 | Local |
Lignes sélectionnées, classement WholeDoc, 5 novembre 2026, prix catalogue. *Score encore en cours d'évaluation.
La continuité entre les pages constitue le principal défaut. Sur 44 documents comportant des tableaux s'étendant sur plusieurs pages, 15 des 19 paramètres parvenaient rarement à les conserver intacts.
Nutrient a développé et exécuté cette solution, et le jeu de test principal est privé. Le code est sous licence Apache-2.0, avec un échantillon public de 10 documents.
Points clés
- Les champs contiennent les pages, les régions, les étiquettes de correspondance et, lorsqu'ils sont disponibles, la confiance.
- Configurez et testez dans Studio avant d'écrire tout code API.
- L'extraction en mode Understand coûte 15 $ pour 1 000 pages.
- Agentic domine le WholeDoc Bench de Nutrient avec un score de 86,2, soit 1,8 ¢ par page.
- Les graphiques restent difficiles : 64,5 est le meilleur score WholeDoc pour les graphiques.
Consultez l'API d'extraction de données, les benchmarks, le serveur MCP et les compétences des agents sur GitHub.
Merci à l'équipe AI de Nutrient pour son leadership intellectuel et les ressources fournies pour cet article. Cet article est sponsorisé.
L'article API d'extraction de données Nutrient : JSON correspondant à votre schéma avec citations et niveaux de confiance par champ a été publié en premier sur MarkTechPost.