
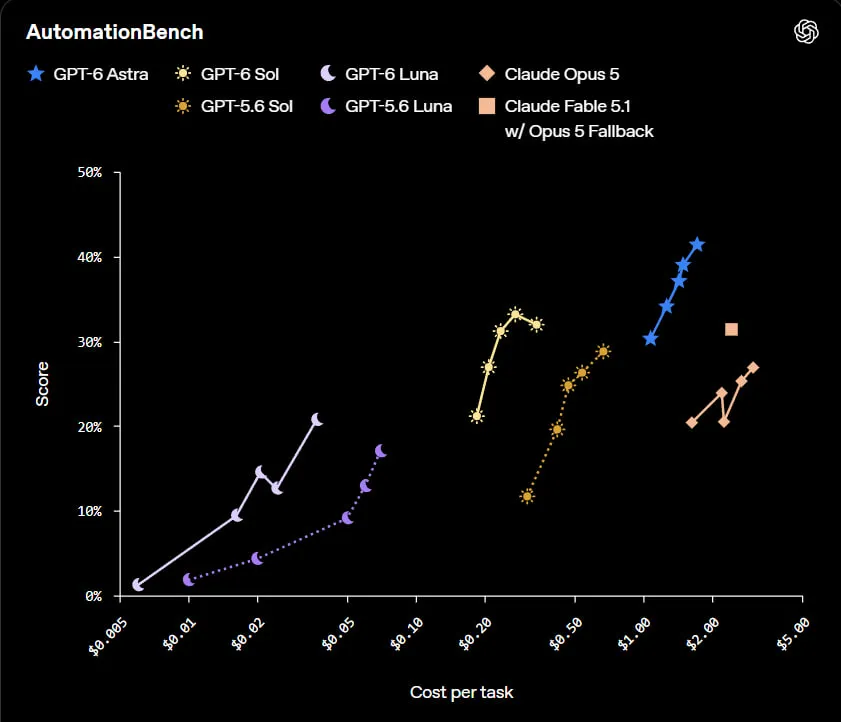
En las pruebas de tareas laborales, AutomationBench Sol supera a Claude Opus 5 (33,2% frente a 26,9%) y a Fable 5.1 (31,4%); además, la ejecución de las tareas resulta aproximadamente 11 veces más barata que en Opus 5.
En las pruebas internas de errores reales, Sol redujo a la mitad el número de fallos en comparación con GPT-5.6. La modelo se acerca en fiabilidad a Astra, pero a un precio inferior. Las tarifas básicas de API para Sol se han reducido en un 50% ($2/$10 por millón de tokens), y para Luna, entre un 50% y un 58%.
Sol está indicado para codificación compleja y tareas agentes (desarrollo de funciones, revisión de código, depuración, análisis de datos); Luna, en cambio, es más adecuada para tareas más sencillas y masivas, como resúmenes y extracción de datos.