
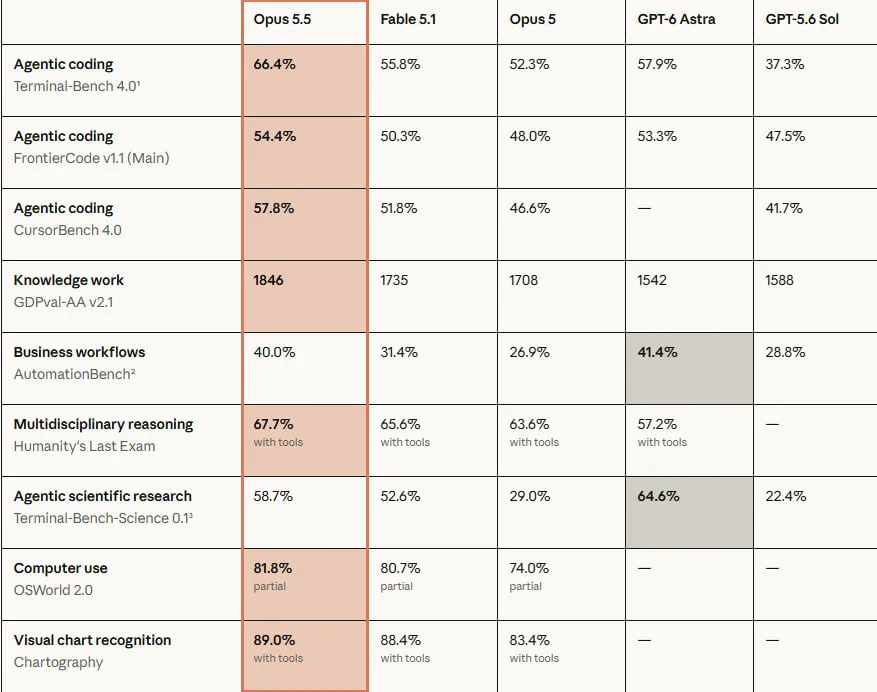
En términos de rendimiento, no le cede terreno a Claude Fable 5.1 en la mayoría de las tareas y resulta un 40% más barata en operación que Opus 5.
En los benchmarks del lanzamiento, esta modelo supera a GPT-5.6 Sol en 6 de 6 pruebas generales, y a GPT-6 Astra en 4 de 6 (pruebas independientes confirman al menos Terminal-Bench 4.0: 66,4% frente a 57,9% para Astra)
Los usuarios destacan un notable aumento en la velocidad en tareas reales; por ejemplo, auditar una base de código de 200.000 líneas tomó menos de 3 horas, comparado con las más de 20 horas de la versión anterior.
Continuar leyendo este artículo en la fuente: anthropic.com