
Un LLM te presenta como hecho un valor erróneo extraído de un documento. Ese error resulta costoso, especialmente cuando se toman decisiones basadas en él. La Nutrient Data Extraction API aborda ese problema. Analiza PDFs, escaneos, imágenes y archivos de Office para convertirlos en JSON espacial o Markdown. Extrae campos de un documento según tu esquema JSON, y las funciones de división, clasificación y creación de formularios proporcionan primitivas útiles para tus pipelines de documentos. Cada valor extraído está anclado a una página mediante un rectángulo delimitador, una etiqueta de coincidencia y una puntuación de confianza. Nutrient (anteriormente PSPDFKit) ejecuta el mismo motor detrás de un servidor MCP, habilidades de agente, aplicación para Mac y SDK.
TL;DR
- Tamaño: Una API alojada con 4 modos de análisis más enrutamiento automático.
- Ejecución en: Nube de Nutrient, tus propios servidores mediante SDK o un Mac con chip Apple.
- Dónde probarla: Studio, un entorno de trabajo en navegador para configurar y probar el análisis, la extracción, la clasificación, la división y el relleno de formularios.
- Rendimiento: 86,2 global en el WholeDoc Bench de Nutrient, líder entre 19 configuraciones (API en vivo, Agentic).
- Mejor opción: 86,2 a 1,8¢ por página, frente a 67,1 a 17,8¢ para la mejor configuración del modelo frontera.
¿Cómo la pruebas en Studio antes de escribir código?
Studio es el entorno de trabajo en navegador de Nutrient para configurar y probar la API antes de integrarla en tu aplicación. Te permite probar el análisis, la extracción, la clasificación, la división y el relleno de formularios en tus propios archivos. Un ciclo típico:
- Sube un documento de ejemplo y establece los parámetros que planeas enviar.
- Diseña un esquema en la interfaz de usuario o genera uno basado en tus propios documentos.
- Ejecútalo en un documento nuevo y luego inspecciona los valores y las citas.
- Guarda la configuración como una preconfiguración versionada. La API la llama procesador, con un ID de proc.
- Evalúa las versiones de las preconfiguraciones contra hasta 25 documentos revisados en un conjunto de evaluación.
Los procesadores guardados en Studio pueden luego ser llamados desde la API mediante su ID.
¿Qué modo deberías elegir?
Auto dirige cada página a estructura, comprensión o agente. Si se omite el modo, la API utiliza comprensión por defecto.
| Operación | Mejor para | Precio por página | Extracción por página | WholeDoc Bench* |
| Análisis: texto | PDFs y archivos de Office nativos digitales, sin OCR | 0,001 $ | 0,007 $** | No probado |
| Análisis: estructura | OCR para escaneos con diseños simples, sin IA | 0,0015 $ | 0,0075 $ | 39,4 |
| Análisis: comprensión | Análisis de diseño con IA: formularios, diseños complejos | 0,009 $ | 0,015 $ | 80,8 |
| Análisis: agente | Modelo de lenguaje visual: escritura cursiva, escaneos deteriorados, gráficos | 0,018 $ | 0,024 $ | 86,2 |
| Clasificación | Etiquetas de documentos zero-shot | 0,001 $ | n/a | n/a |
| División | Separar PDFs fusionados en documentos | 0,003 $ | n/a | n/a |
*Puntuación de análisis del WholeDoc Bench, 5 de noviembre de 2026; no es precisión de extracción. La extracción añade 0,006 $ por página. **La documentación de la API indica extracción en modo texto; la habilidad de agente comienza en estructura.
Los precios están en dólares, con 1 saldo compartido a través de las API en la nube de Nutrient, para que los equipos puedan combinar y adaptar. El plan gratuito ofrece 5 USD de uso mensual, suficiente para aproximadamente 330 extracciones en modo comprensión. Starter cuesta 75 USD al mes por 90 USD de uso; Growth cuesta 275 USD por 345 USD.
¿Cómo funciona la confianza fundamentada?
En la publicación de confianza de Nutrient, un campo obtuvo una puntuación de 0,97 pero provenía de la columna incorrecta.
La puntuación actual es un composite de señales opcionales: probabilidad del token, margen del candidato, fundamentación y formato. El modelo de fundamentación de NLI de Nutrient está disponible bajo Apache-2.0. Un valor fundamentado aún puede responder al campo equivocado. Cuando no existe puntuación, se omite la confianza, no se considera baja.
Cada campo también recibe una etiqueta de coincidencia: id_match, id_match_multiblock, id_match_partial, fuzzy_match o not_found. Filtrar primero por la etiqueta y luego por la confianza.
Copiar códigoCopiadoUsar otro navegador
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "Número de factura debajo de los detalles del proveedor."},
        "total_amount": {"type": "number", "description": "Importe total final impreso, incluido el impuesto. No es el subtotal."},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # solo ilustrativo; evaluar en documentos representativos

for field in schema["properties"]:  # iterar sobre los campos esperados para que ninguno salte la revisión
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = sin puntuación
    passes = (value is not None y match en EXACT
              y conf is not None y conf >= THRESHOLD)
    print(field, value, match, conf, "página", meta.get("pageNumber"),
          "PASA_VERIFICACIONES_BÁSICAS" si pasa else "REVISIÓN")
Esta demostración cubre solo esquemas planos; la producción requiere verificaciones de tipo y reglas comerciales. La barrera de 0,97 refleja los campos monetarios en el tutorial hipotecario de Nutrient.
¿Cómo funcionan classify y split?
Un modelo de decisión documental alimenta classify y split. Nutrient informa una F1 de división del 96,2% frente al 63,7% de Jev de Typesafe AI.
¿Cómo lo utilizan los agentes?
El servidor MCP alojado no necesita clave API. Claude Code se conecta con 1 comando:
Copiar códigoCopiadoUsar otro navegador
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude y Codex también funcionan mediante OAuth. El modo agente predeterminado cuesta 0,018 USD por página procesada.
Los agentes programadores pueden instalar la habilidad document-extraction-api con npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api.
¿Se puede ejecutar localmente?
En la aplicación para Mac, los documentos permanecen locales únicamente con un modelo local. La producción completamente offline requiere el SDK.
¿Cómo puntúa en WholeDoc Bench?
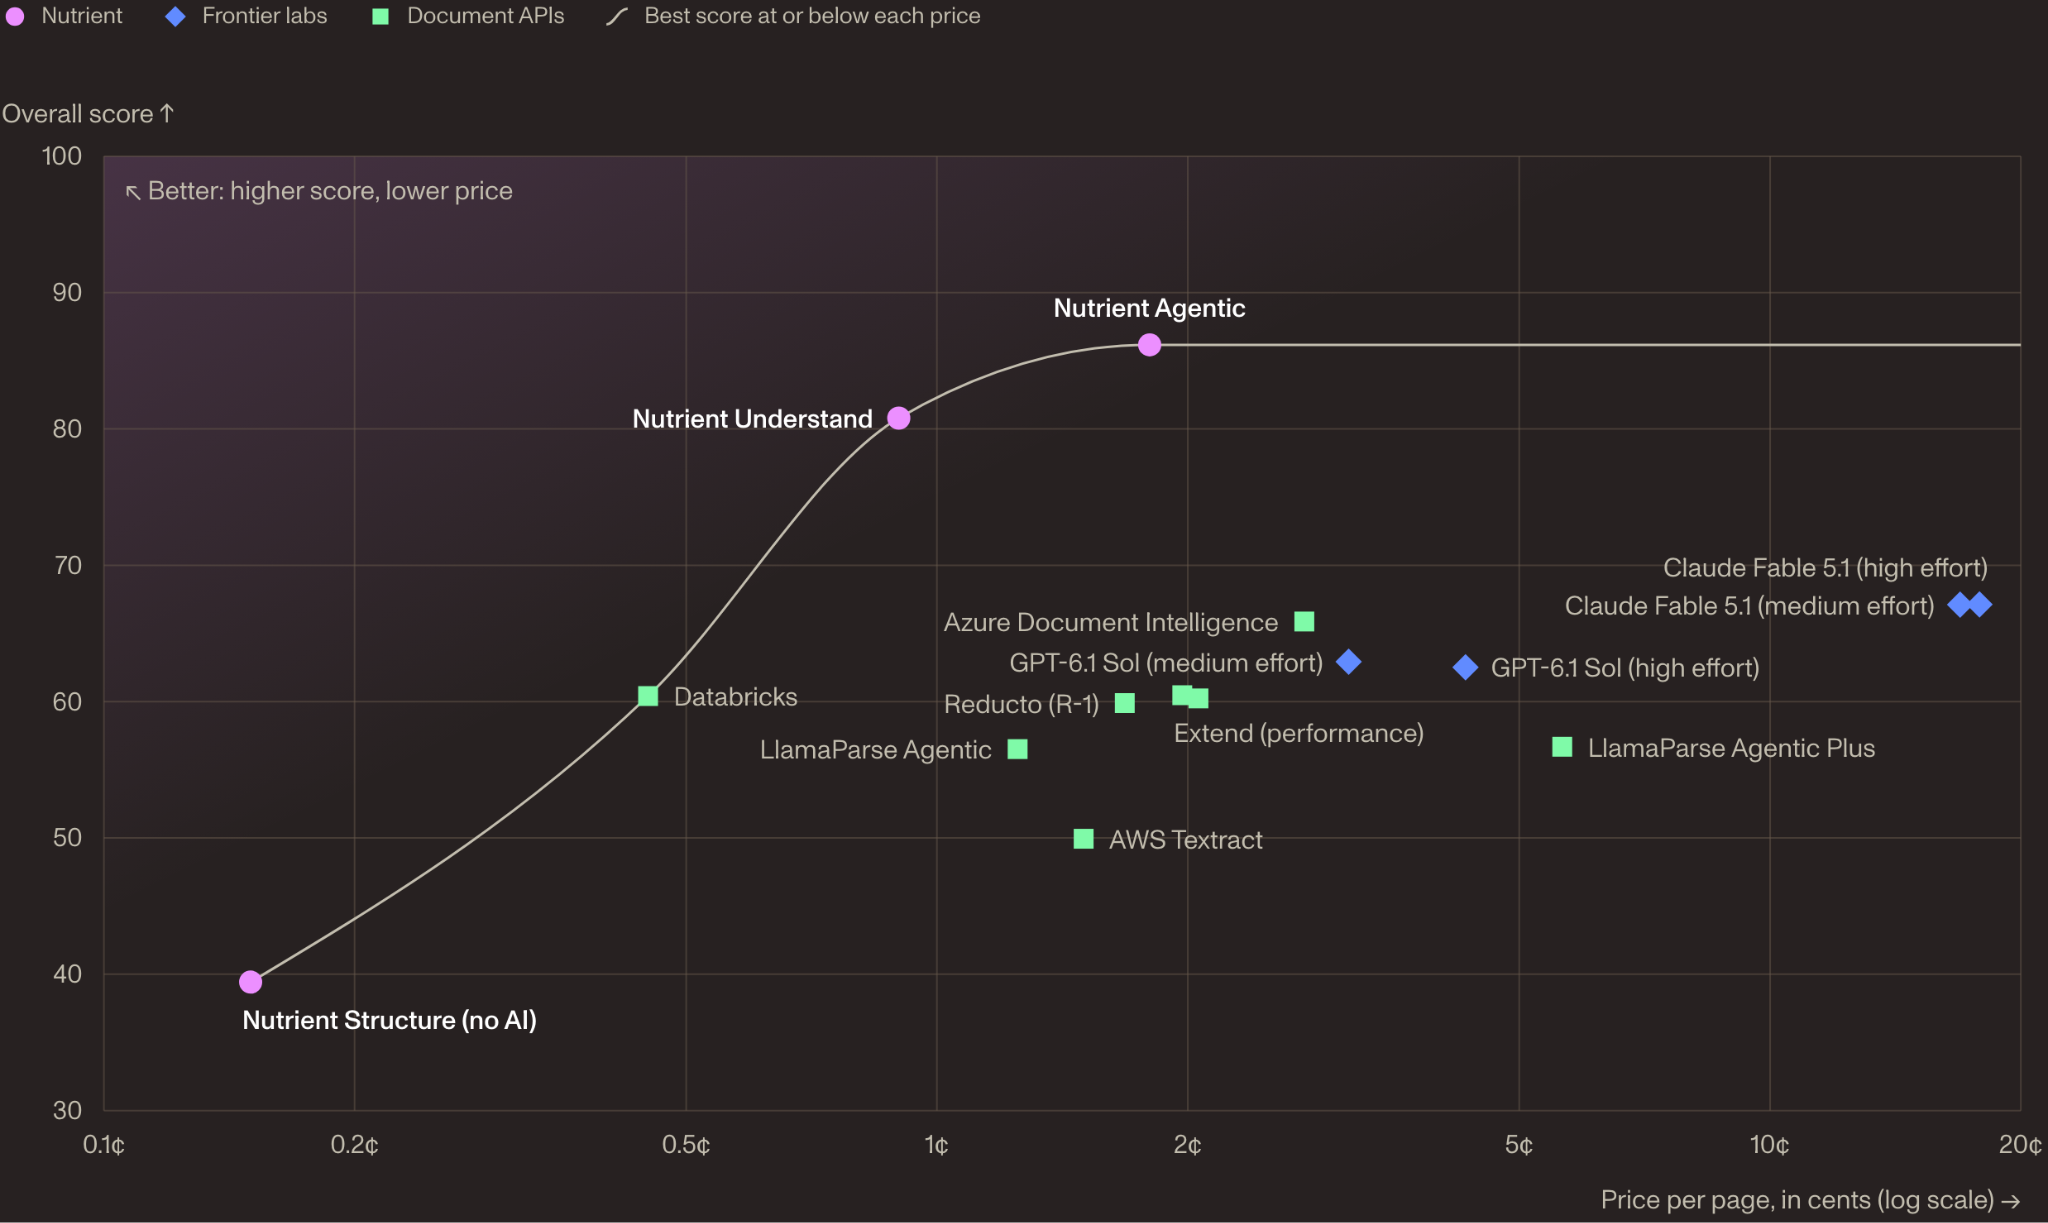
El nuevo WholeDoc Bench de Nutrient puntúa documentos completos, no páginas individuales: 480 documentos, más de 30 idiomas, 7 áreas.
| Configuración | General | Tablas | Gráficos | Posición | ¢/página |
| Nutrient Agentic | 86.2 | 87.1 | 64.5 | 88.6 | 1.8 |
| Nutrient Understand | 80.8 | 86.1 | 35.1 | 86.4 | 0.9 |
| Claude Fable 5.1 (alto esfuerzo) | 67.1 | 84.7 | 58.9 | 66.0 | 17.8 |
| Azure Document Intelligence | 65.9 | 69.4 | 0 | 72.5 | ≈2.8 |
| GPT-6.1 Sol (esfuerzo medio) | 62.9 | 82.8 | 47.6 | 49.3 | ≈3.1 |
| Extend (rendimiento) | 60.5 | 80.8 | 40.6 | 75.2 | 2.0 |
| Reducto (R-1) | 59.9 | 76.4 | 38.5 | 76.4 | ≈1.7 |
| LlamaParse Agentic Plus | 56.7 | 89.5 | 0* | 65.4 | ≈5.6 |
| AWS Textract | 49.9 | 71.4 | 0 | 70.0 | 1.5 |
| Docling | 40.0 | 63.9 | 20.2 | 0 | Local |
Filas seleccionadas, tabla de clasificación WholeDoc, 5 de noviembre de 2026, precios de lista. *Puntuación aún bajo revisión.
La continuidad entre páginas es la mayor brecha. En 44 documentos con tablas que abarcan varias páginas, 15 de 19 configuraciones rara vez las mantuvieron completas.
Nutrient lo desarrolló y ejecutó, y el conjunto principal de pruebas es privado. El código está bajo licencia Apache-2.0, con una muestra pública de 10 documentos.
Conclusiones clave
- Los campos incluyen páginas, regiones, etiquetas de coincidencia y, cuando están disponibles, confianza.
- Configure y pruebe en Studio antes de escribir cualquier código API.
- La extracción en modo Understand cuesta $15 por cada 1.000 páginas.
- Agentic lidera el WholeDoc Bench de Nutrient con 86.2 a 1.8¢ por página.
- Los gráficos siguen siendo difíciles: 64.5 es la mejor puntuación WholeDoc para gráficos.
Consulte la API de extracción de datos, los benchmarks, el servidor MCP y la habilidad del agente en GitHub.
Agradecemos al equipo de IA de Nutrient por su liderazgo intelectual y los recursos proporcionados para este artículo. Este artículo es patrocinado.
La publicación API de extracción de datos de Nutrient: JSON que coincide con su esquema con citas y confianza por campo apareció primero en MarkTechPost.