
একটি LLM কোনো নথি থেকে প্রাপ্ত ভুল মানকে সত্য হিসেবে উপস্থাপন করে। এই ধরনের ত্রুটি ব্যয়বহুল, বিশেষ করে যখন সিদ্ধান্ত গ্রহণের ভিত্তি হিসেবে এটি ব্যবহার করা হয়। Nutrient Data Extraction API এই সমস্যাটিকে লক্ষ্য করে। এটি PDF, স্ক্যান, ছবি এবং Office ফাইলকে স্থানিক JSON বা Markdown-এ রূপান্তর করে। নথি থেকে মানগুলোকে আপনার JSON স্কিমায় নিয়ে আসুন, এবং বিভক্ত, শ্রেণীবদ্ধ ও ফর্ম তৈরির মাধ্যমে আপনার ডকুমেন্ট পাইপলাইনের জন্য দরকারী মৌলিক উপাদান প্রদান করুন। প্রতিটি নির্গত মান একটি বাউন্ডিং বক্স, একটি ম্যাচ লেবেল এবং একটি কনফিডেন্স স্কোরের মাধ্যমে একটি পৃষ্ঠার সাথে যুক্ত থাকে। Nutrient (পূর্বে PSPDFKit) একই ইঞ্জিন ব্যবহার করে MCP server, এজেন্ট স্কিল, Mac app এবং SDK-এর পেছনে।
TL;DR
- আকার: 4টি পার্স মোড সহ একটি হোস্টেড API এবং অটো রুটিং।
- চালানো যায়: Nutrient ক্লাউড, SDK মাধ্যমে আপনার নিজস্ব সার্ভার বা Apple silicon Mac-এ।
- পরীক্ষা করার জন্য: Studio, একটি ব্রাউজার-ভিত্তিক ওয়ার্কস্পেস যেখানে পার্সিং, নির্গমন, শ্রেণীবদ্ধকরণ, বিভক্তকরণ এবং ফর্ম পূরণ করা যায়।
- কর্মক্ষমতা: Nutrient’s WholeDoc Bench-এ সামগ্রিক 86.2, 19টি সেটিংসের মধ্যে শীর্ষস্থানীয় (লাইভ API, Agentic)।
- সেরা: প্রতি পৃষ্ঠা 1.8¢-এ 86.2, যা সেরা ফ্রন্টিয়ার-মডেল সেটিংসের 67.1 এবং 17.8¢-এর বিপরীতে।
কোড লেখার আগে Studio-তে এটি কীভাবে পরীক্ষা করবেন?
Studio হল Nutrient-এর ব্রাউজার-ভিত্তিক ওয়ার্কস্পেস যেখানে আপনার অ্যাপ্লিকেশনে এটি ইন্টিগ্রেট করার আগে API-এর কনফিগারেশন এবং পরীক্ষা করা যায়। এটি আপনাকে পার্সিং, নির্গমন, শ্রেণীবদ্ধকরণ, বিভক্তকরণ এবং ফর্ম পূরণ পরীক্ষা করতে সক্ষম করে। একটি সাধারণ লুপ:
- একটি নমুনা নথি আপলোড করুন এবং আপনি প্রেরণ করার পরিকল্পনা করা প্যারামিটারগুলো সেট করুন।
- UI-তে একটি স্কিমা ড্রাফট করুন, অথবা আপনার নিজস্ব নথির উপর ভিত্তি করে একটি তৈরি করুন।
- একটি নতুন নথিতে এটি চালান, তারপর মান এবং উদ্ধৃতিগুলো পরীক্ষা করুন।
- সেটআপটিকে একটি ভার্সনযুক্ত প্রিসেট হিসেবে সংরক্ষণ করুন। API এটিকে প্রসেসর হিসেবে উল্লেখ করে, যার একটি proc_ ID থাকে।
- একটি মূল্যায়ন সেটে 25টি পর্যন্ত পর্যালোচিত নথির সাথে প্রিসেটের ভার্সনগুলোর তুলনা করুন।
Studio-তে সংরক্ষিত প্রসেসরগুলো এখন আইডি দ্বারা API-তে কল করা যেতে পারে।
আপনার কোন মোড বেছে নেওয়া উচিত?
Auto প্রতিটি পৃষ্ঠাকে structure, understand বা agentic-এ রুট করে। যদি মোডটি উপেক্ষা করা হয়, API ডিফল্টরূপে understand নির্বাচন করে।
| অপারেশন | েরা জন্য | প্রতি পৃষ্ঠার মূল্য | প্রতি পৃষ্ঠার নির্গমন | WholeDoc Bench* |
| পার্স: টেক্সট | জন্মগতভাবে ডিজিটাল PDF এবং Office ফাইল, OCR ছাড়া | $0.001 | $0.007** | পরীক্ষা করা হয়নি |
| পার্স: structure | াধারণ লেআউট সহ স্ক্যানের জন্য OCR, AI ছাড়া | $0.0015 | $0.0075 | 39.4 |
| পার্স: understand | AI লেআউট বিশ্লেষণ: ফর্ম, জটিল লেআউট | $0.009 | $0.015 | 80.8 |
| পার্স: agentic | িশন ল্যাঙ্গুয়েজ মডেল: কার্সিভ, ক্ষতিগ্রস্ত স্ক্যান, চার্ট | $0.018 | $0.024 | 86.2 |
| শ্রেণীবদ্ধকরণ | জিরো-শট ডকুমেন্ট লেবেল | $0.001 | n/a | n/a |
| বিভক্তকরণ | মার্জড PDF-কে পৃথক নথিতে পৃথক করা | $0.003 | n/a | n/a |
*WholeDoc Bench পার্সিং স্কোর, 5 নভেম্বর 2026; নির্গমন নির্ভুলতা নয়। নির্গমনে প্রতি পৃষ্ঠায় $0.006 যোগ হয়। **API ডকুমেন্টে টেক্সট-মোড নির্গমনের কথা বলা হয়েছে; এজেন্ট স্কিল শুরু হয় structure-এ।
মূল্য নির্ধারণ ডলারে, Nutrient-এর ক্লাউড API-গুলিতে ভাগ করা 1টি ব্যালেন্স থেকে, যাতে দলগুলি বিভিন্ন জিনিস মিশিয়ে ব্যবহার করতে পারে। ফ্রি প্ল্যানে আপনি প্রতি মাসে $5 ব্যবহারের সুবিধা পান, যা প্রায় 330টি understand-mode এক্সট্রাকশন কভার করে। Starter প্ল্যানের খরচ $75 প্রতি মাসে, যেখানে $90 ব্যবহারের সুবিধা পাওয়া যায়; Growth প্ল্যানের খরচ $275, যেখানে $345 ব্যবহারের সুবিধা পাওয়া যায়।
Grounded Confidence কীভাবে কাজ করে?
Nutrient-এর confidence post-এ, একটি ফিল্ডে 0.97 স্কোর পাওয়া গেছে কিন্তু এটি ভুল কলাম থেকে এসেছে।
বর্তমান স্কোরটি ঐচ্ছিক সিগন্যালের একটি composite: টোকেন সম্ভাব্যতা, ক্যান্ডিডেট মার্জিন, গ্রাউন্ডিং এবং ফরম্যাট। Nutrient-এর NLI grounding model Apache-2.0 অধীনে উন্মুক্ত। একটি গ্রাউন্ডেড ভ্যালু এখনও ভুল ফিল্ডের উত্তর দিতে পারে। যখন কোনো স্কোর না থাকে, তখন confidence বাদ দেওয়া হয়, নিম্ন নয়।
প্রতিটি ফিল্ডের জন্য একটি ম্যাচ লেবেলও দেওয়া হয়: id_match, id_match_multiblock, id_match_partial, fuzzy_match অথবা not_found। প্রথমে লেবেলের উপর নজর দিন, তারপর কনফিডেন্সের দিকে।
কোড কপি করুনকপি করা হয়েছেঅন্য ব্রাউজার ব্যবহার করুন
import json, requests

API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "Suppliers-এর বিবরণের নিচে ইনভয়েস নম্বর।"},
        "total_amount": {"type": "number", "description": "ট্যাক্সসহ মুদ্রিত চূড়ান্ত মোট। সাবটোটাল নয়।"},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}

with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}

EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # শুধুমাত্র উদাহরণস্বরূপ; প্রতিনিধিত্বমূলক ডকুমেন্টে মূল্যায়ন করুন

for field in schema["properties"]:  # প্রত্যাশিত ফিল্ডগুলির মধ্যে লুপ করুন যাতে কেউ পর্যালোচনা এড়াতে না পারে
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = কোনো স্কোর নেই
    passes = (value is not None and match in EXACT
              and conf is not None and conf >= THRESHOLD)
    print(field, value, match, conf, "page", meta.get("pageNumber"),
          "PASSES_BASIC_CHECKS" if passes else "REVIEW")
এই ডেমো শুধুমাত্র ফ্ল্যাট স্কিমাই কভার করে; প্রোডাকশনে টাইপ এবং বিজনেস-রুল চেক প্রয়োজন। 0.97 বারটি Nutrient-এর mortgage tutorial-এ মানি ফিল্ডের সাথে মিলে যায়।
Classify এবং Split কীভাবে কাজ করে?
Document decision model classify এবং split-এর জন্য শক্তি জোগায়। Nutrient রিপোর্ট করেছে যে Jev-এর Typesafe AI-এর তুলনায় স্প্লিট F1 96.2% এর বিপরীতে 63.7%।
এজেন্টরা এটি কীভাবে ব্যবহার করে?
হোস্টেড MCP সার্ভারের জন্য কোনো API কী লাগে না। Claude Code 1টি কমান্ডের সাথে সংযুক্ত হয়:
কোড কপি করুনকপি করা হয়েছেঅন্য ব্রাউজার ব্যবহার করুন
claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp
Claude এবং Codex OAuth-এর মাধ্যমেও কাজ করে। ডিফল্ট এজেন্টিক মোডের খরচ প্রতি পৃষ্ঠা পার্স করতে $0.018।
কোডিং এজেন্টরা document-extraction-api skill npx skills add pspdfkit-labs/nutrient-skills –skill document-extraction-api ইনস্টল করতে পারে।
এটি স্থানীয়ভাবে চালানো যায় কি?
Mac অ্যাপে, ডকুমেন্টগুলি শুধুমাত্র স্থানীয় মডেলের সাথে স্থানীয় থাকে। সম্পূর্ণ অফলাইন প্রোডাকশনের জন্য SDK প্রয়োজন।
WholeDoc Bench-এ এটি কীভাবে স্কোর করে?
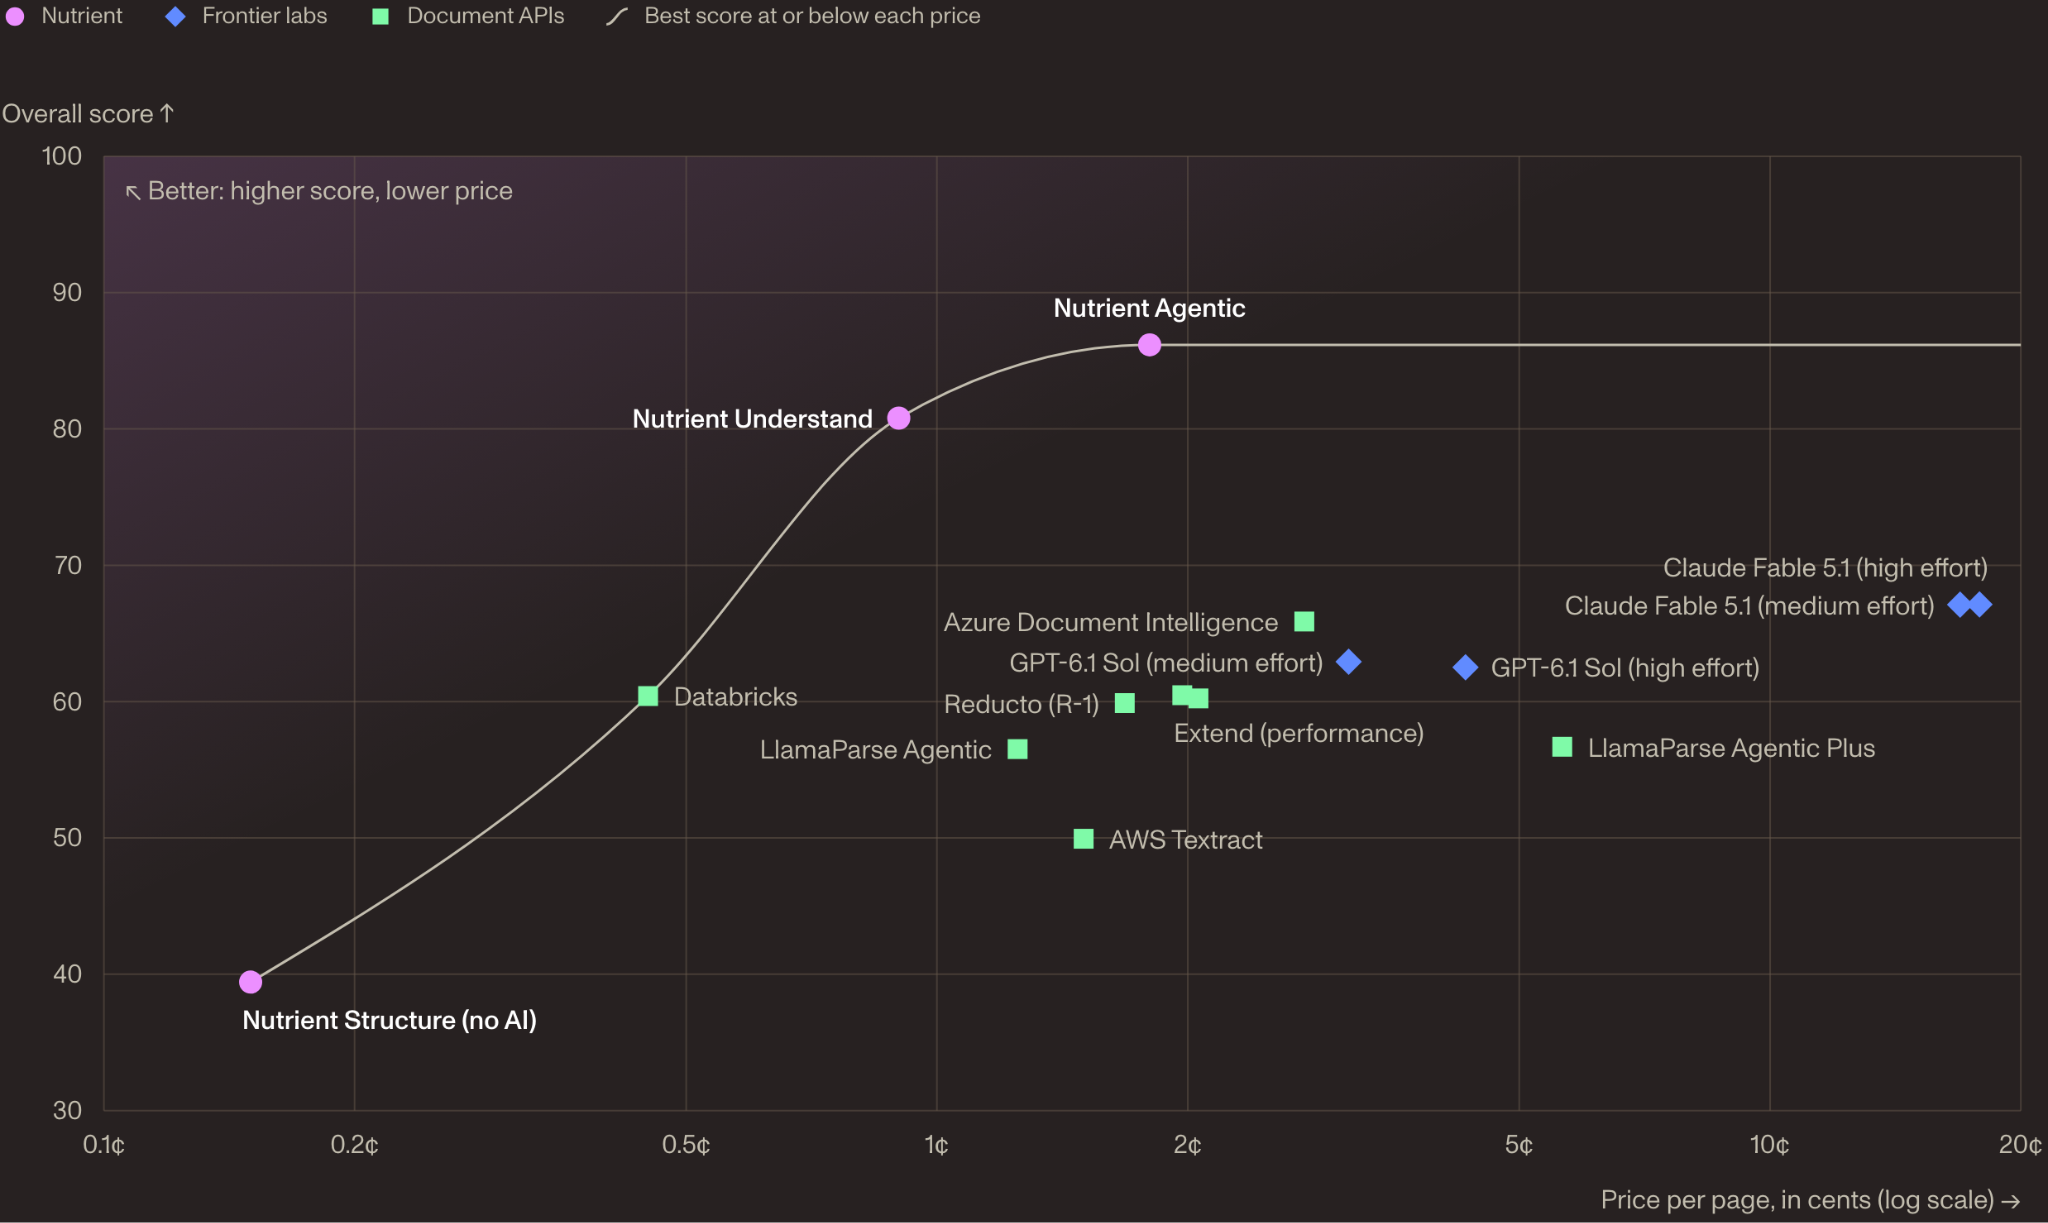
Nutrient-এর নতুন WholeDoc Bench একক পৃষ্ঠা নয়, বরং সমগ্র ডকুমেন্টের স্কোর দেয়: 480টি ডকুমেন্ট, 30টিরও বেশি ভাষা, 7টি ক্ষেত্র।
| সেটিং | ামগ্রিক | টেবিল | ার্ট | অবস্থান | ¢/পৃষ্ঠা |
| Nutrient Agentic | 86.2 | 87.1 | 64.5 | 88.6 | 1.8 |
| Nutrient Understand | 80.8 | 86.1 | 35.1 | 86.4 | 0.9 |
| Claude Fable 5.1 (উচ্চ প্রচেষ্টা) | 67.1 | 84.7 | 58.9 | 66.0 | 17.8 |
| Azure Document Intelligence | 65.9 | 69.4 | 0 | 72.5 | ≈2.8 |
| GPT-6.1 Sol (মাঝারি প্রচেষ্টা) | 62.9 | 82.8 | 47.6 | 49.3 | ≈3.1 |
| Extend (কর্মক্ষমতা) | 60.5 | 80.8 | 40.6 | 75.2 | 2.0 |
| Reducto (R-1) | 59.9 | 76.4 | 38.5 | 76.4 | ≈1.7 |
| LlamaParse Agentic Plus | 56.7 | 89.5 | 0* | 65.4 | ≈5.6 |
| AWS Textract | 49.9 | 71.4 | 0 | 70.0 | 1.5 |
| Docling | 40.0 | 63.9 | 20.2 | 0 | ্থানীয় |
নির্বাচিত সারি, WholeDoc leaderboard, 5 নভেম্বর 2026, তালিকাভুক্ত মূল্য। *স্কোর এখনও পর্যালোচনাধীন।
পৃষ্ঠা জুড়ে অবিচ্ছিন্নতা হলো সবচেয়ে বড় ব্যবধান। পৃষ্ঠা জুড়ে বিস্তৃত টেবিল সহ 44টি ডকুমেন্টের মধ্যে, 19টি সেটিংয়ের মধ্যে 15টিই সেগুলো সম্পূর্ণ রাখতে পারেনি।
Nutrient এটি তৈরি ও চালায়, এবং প্রধান পরীক্ষার সেটটি গোপন। কোড Apache-2.0 লাইসেন্সের অধীনে, সাথে 10টি ডকুমেন্টের একটি জনসাধারণের নমুনা।
মূল প্রাপ্তি
- ফিল্ডগুলো পৃষ্ঠা, অঞ্চল, ম্যাচ লেবেল এবং উপলব্ধ হলে নির্ভরযোগ্যতাও বহন করে।
- কোনো API কোড লেখার আগে Studio-তে কনফিগার করুন এবং পরীক্ষা করুন।
- Understand-মোডে এক্সট্রাকশনের খরচ 1,000 পৃষ্ঠার জন্য $15।
- Agentic Nutrient-এর WholeDoc Bench-এ 86.2 স্কোর নিয়ে শীর্ষে, প্রতি পৃষ্ঠায় 1.8¢।
- চার্ট এখনও কঠিন: WholeDoc-এর সেরা চার্ট স্কোর 64.5।
Data Extraction API, benchmarks, MCP server এবং agent skill on GitHub দেখুন।
এই নিবন্ধের জন্য নেতৃত্ব ও সম্পদ প্রদানের জন্য Nutrient AI দলকে ধন্যবাদ। এই নিবন্ধটি স্পনসর করা হয়েছে।
পোস্ট Nutrient Data Extraction API: JSON Matching Your Schema With Per-Field Citations and Confidence প্রথমে প্রকাশিত হয়েছিল MarkTechPost-এ।